파이썬 pathlib 활용 폴더 파일 이름 일괄 변경 방법과 안전한 실무 적용 가이드
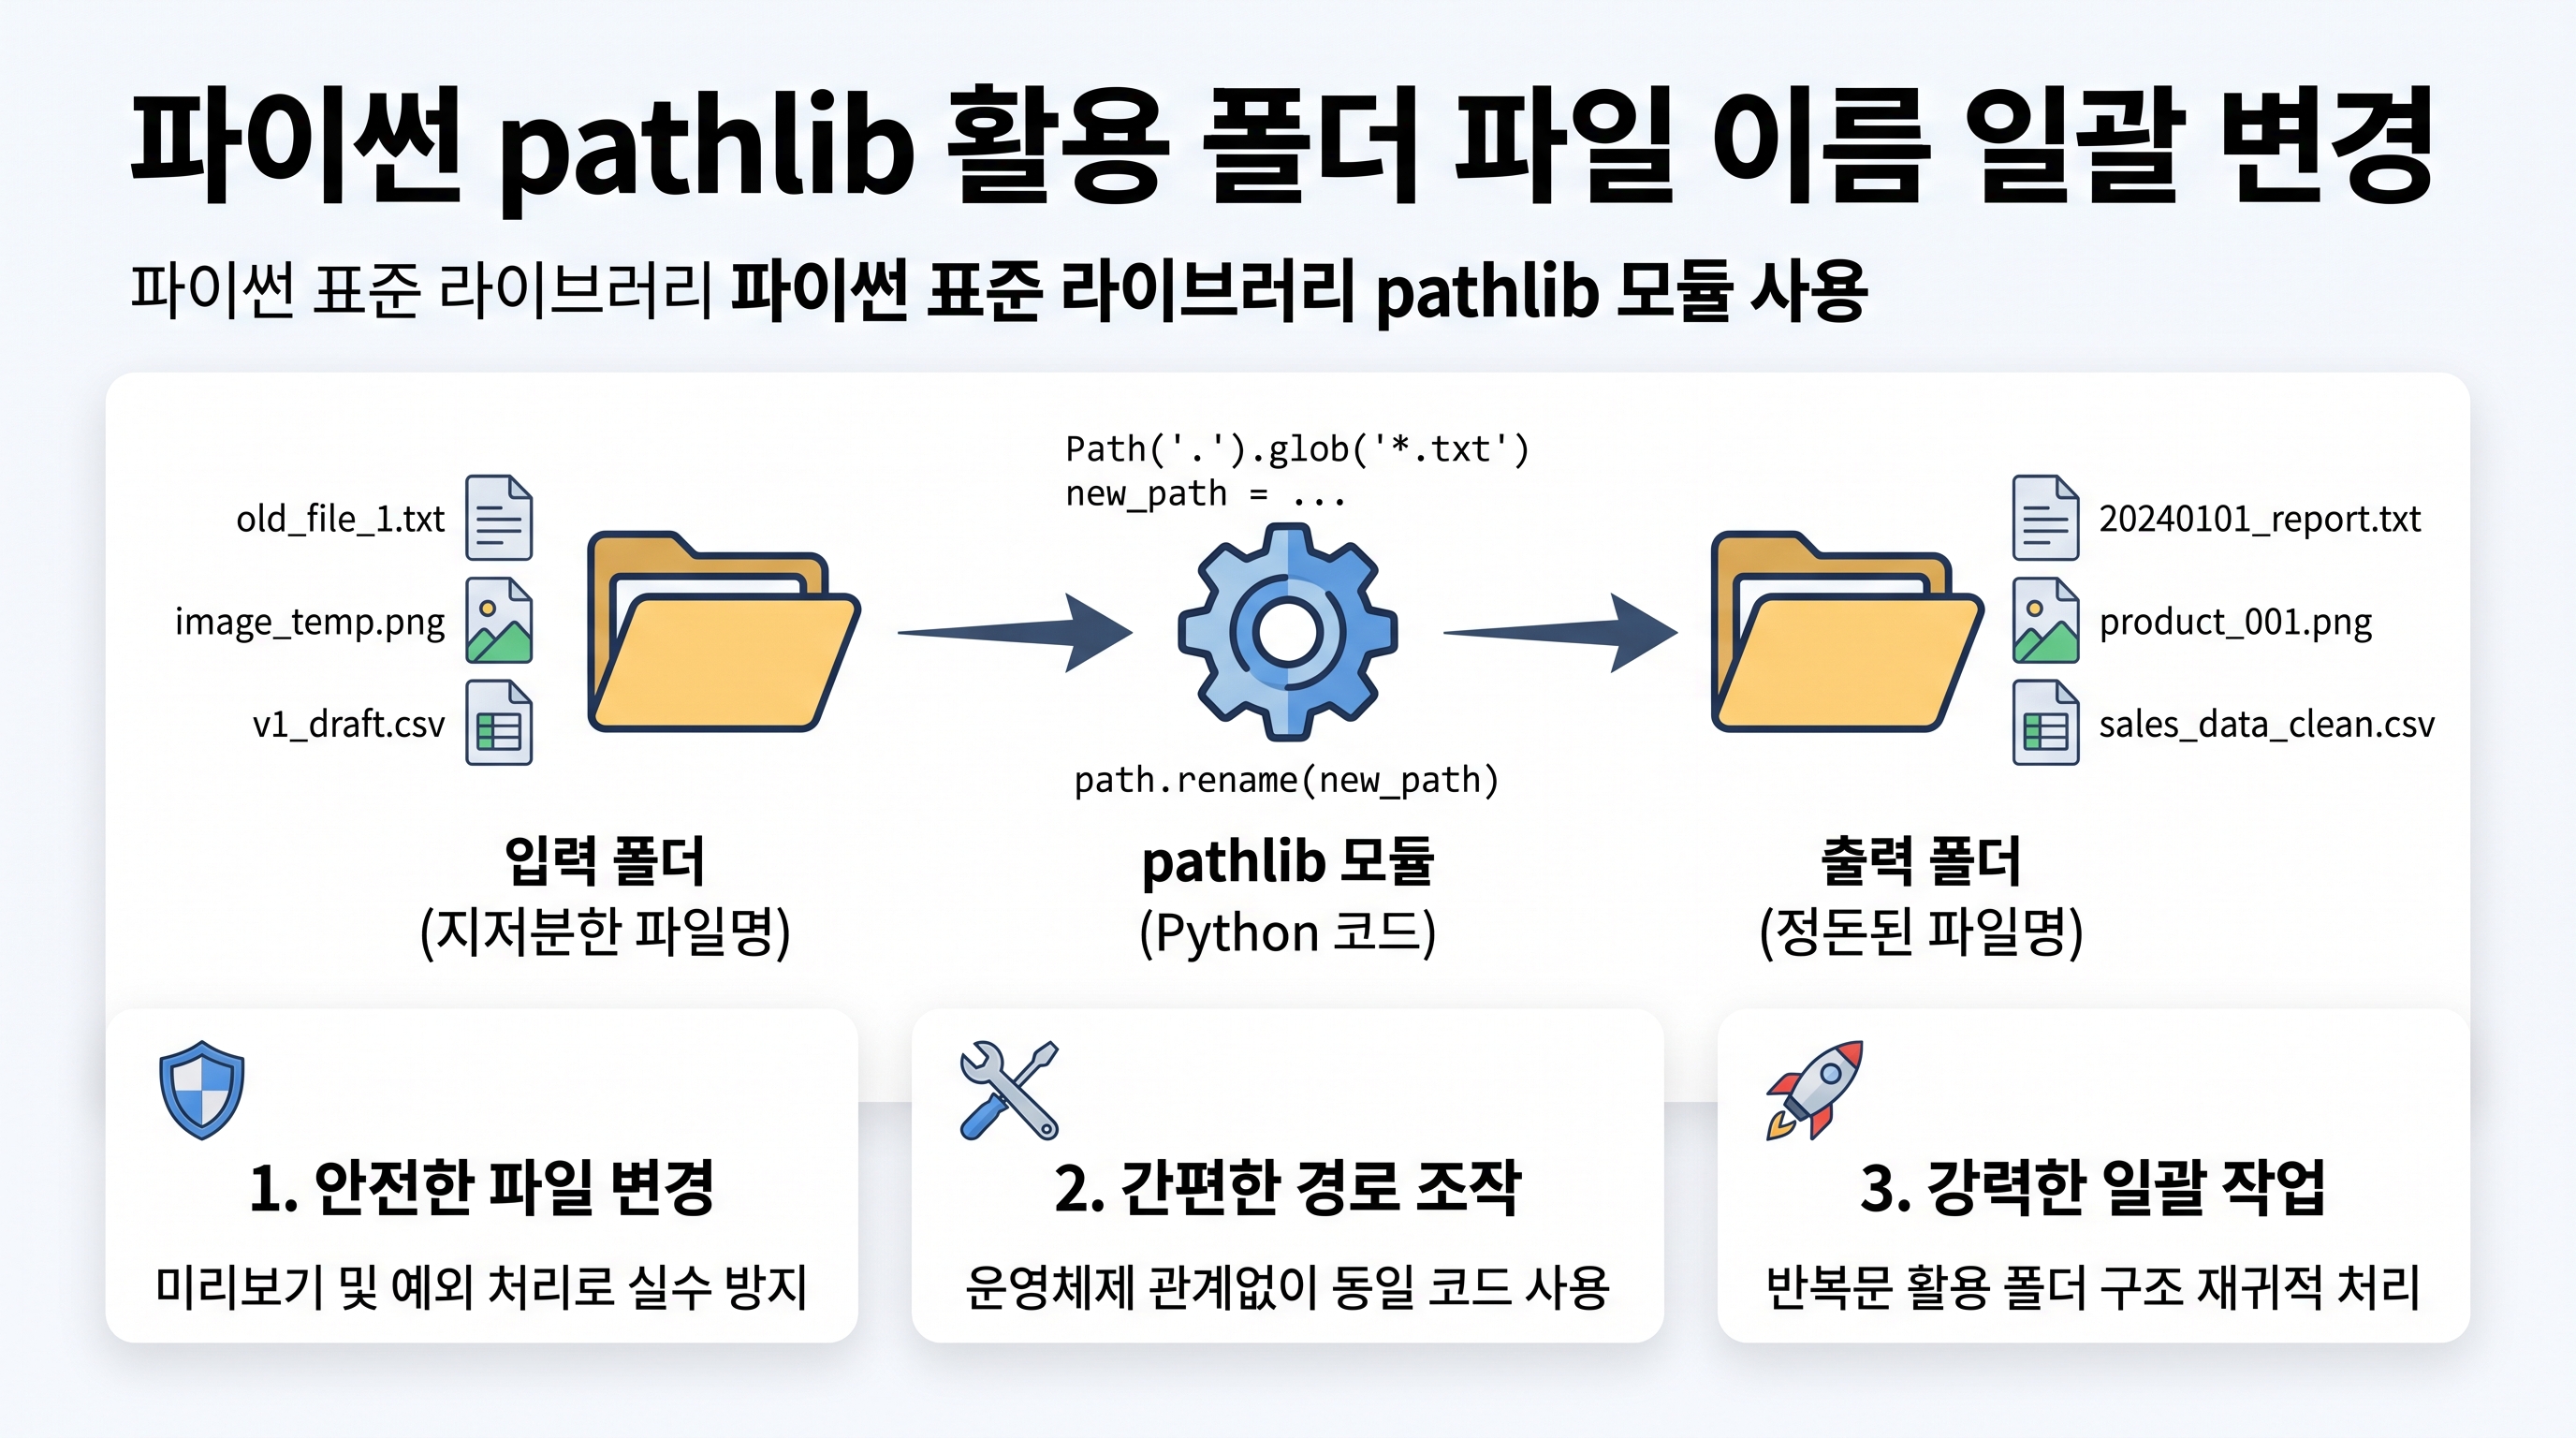
파이썬 표준 라이브러리 pathlib 모듈을 사용해 폴더 안의 파일 이름을 일괄 변경하는 실무 기초 가이드입니다. stem과 suffix 분리, 미리보기(Dry-run) 검증, 중복 덮어쓰기 방지 원칙까지 단계별로 안내합니다.
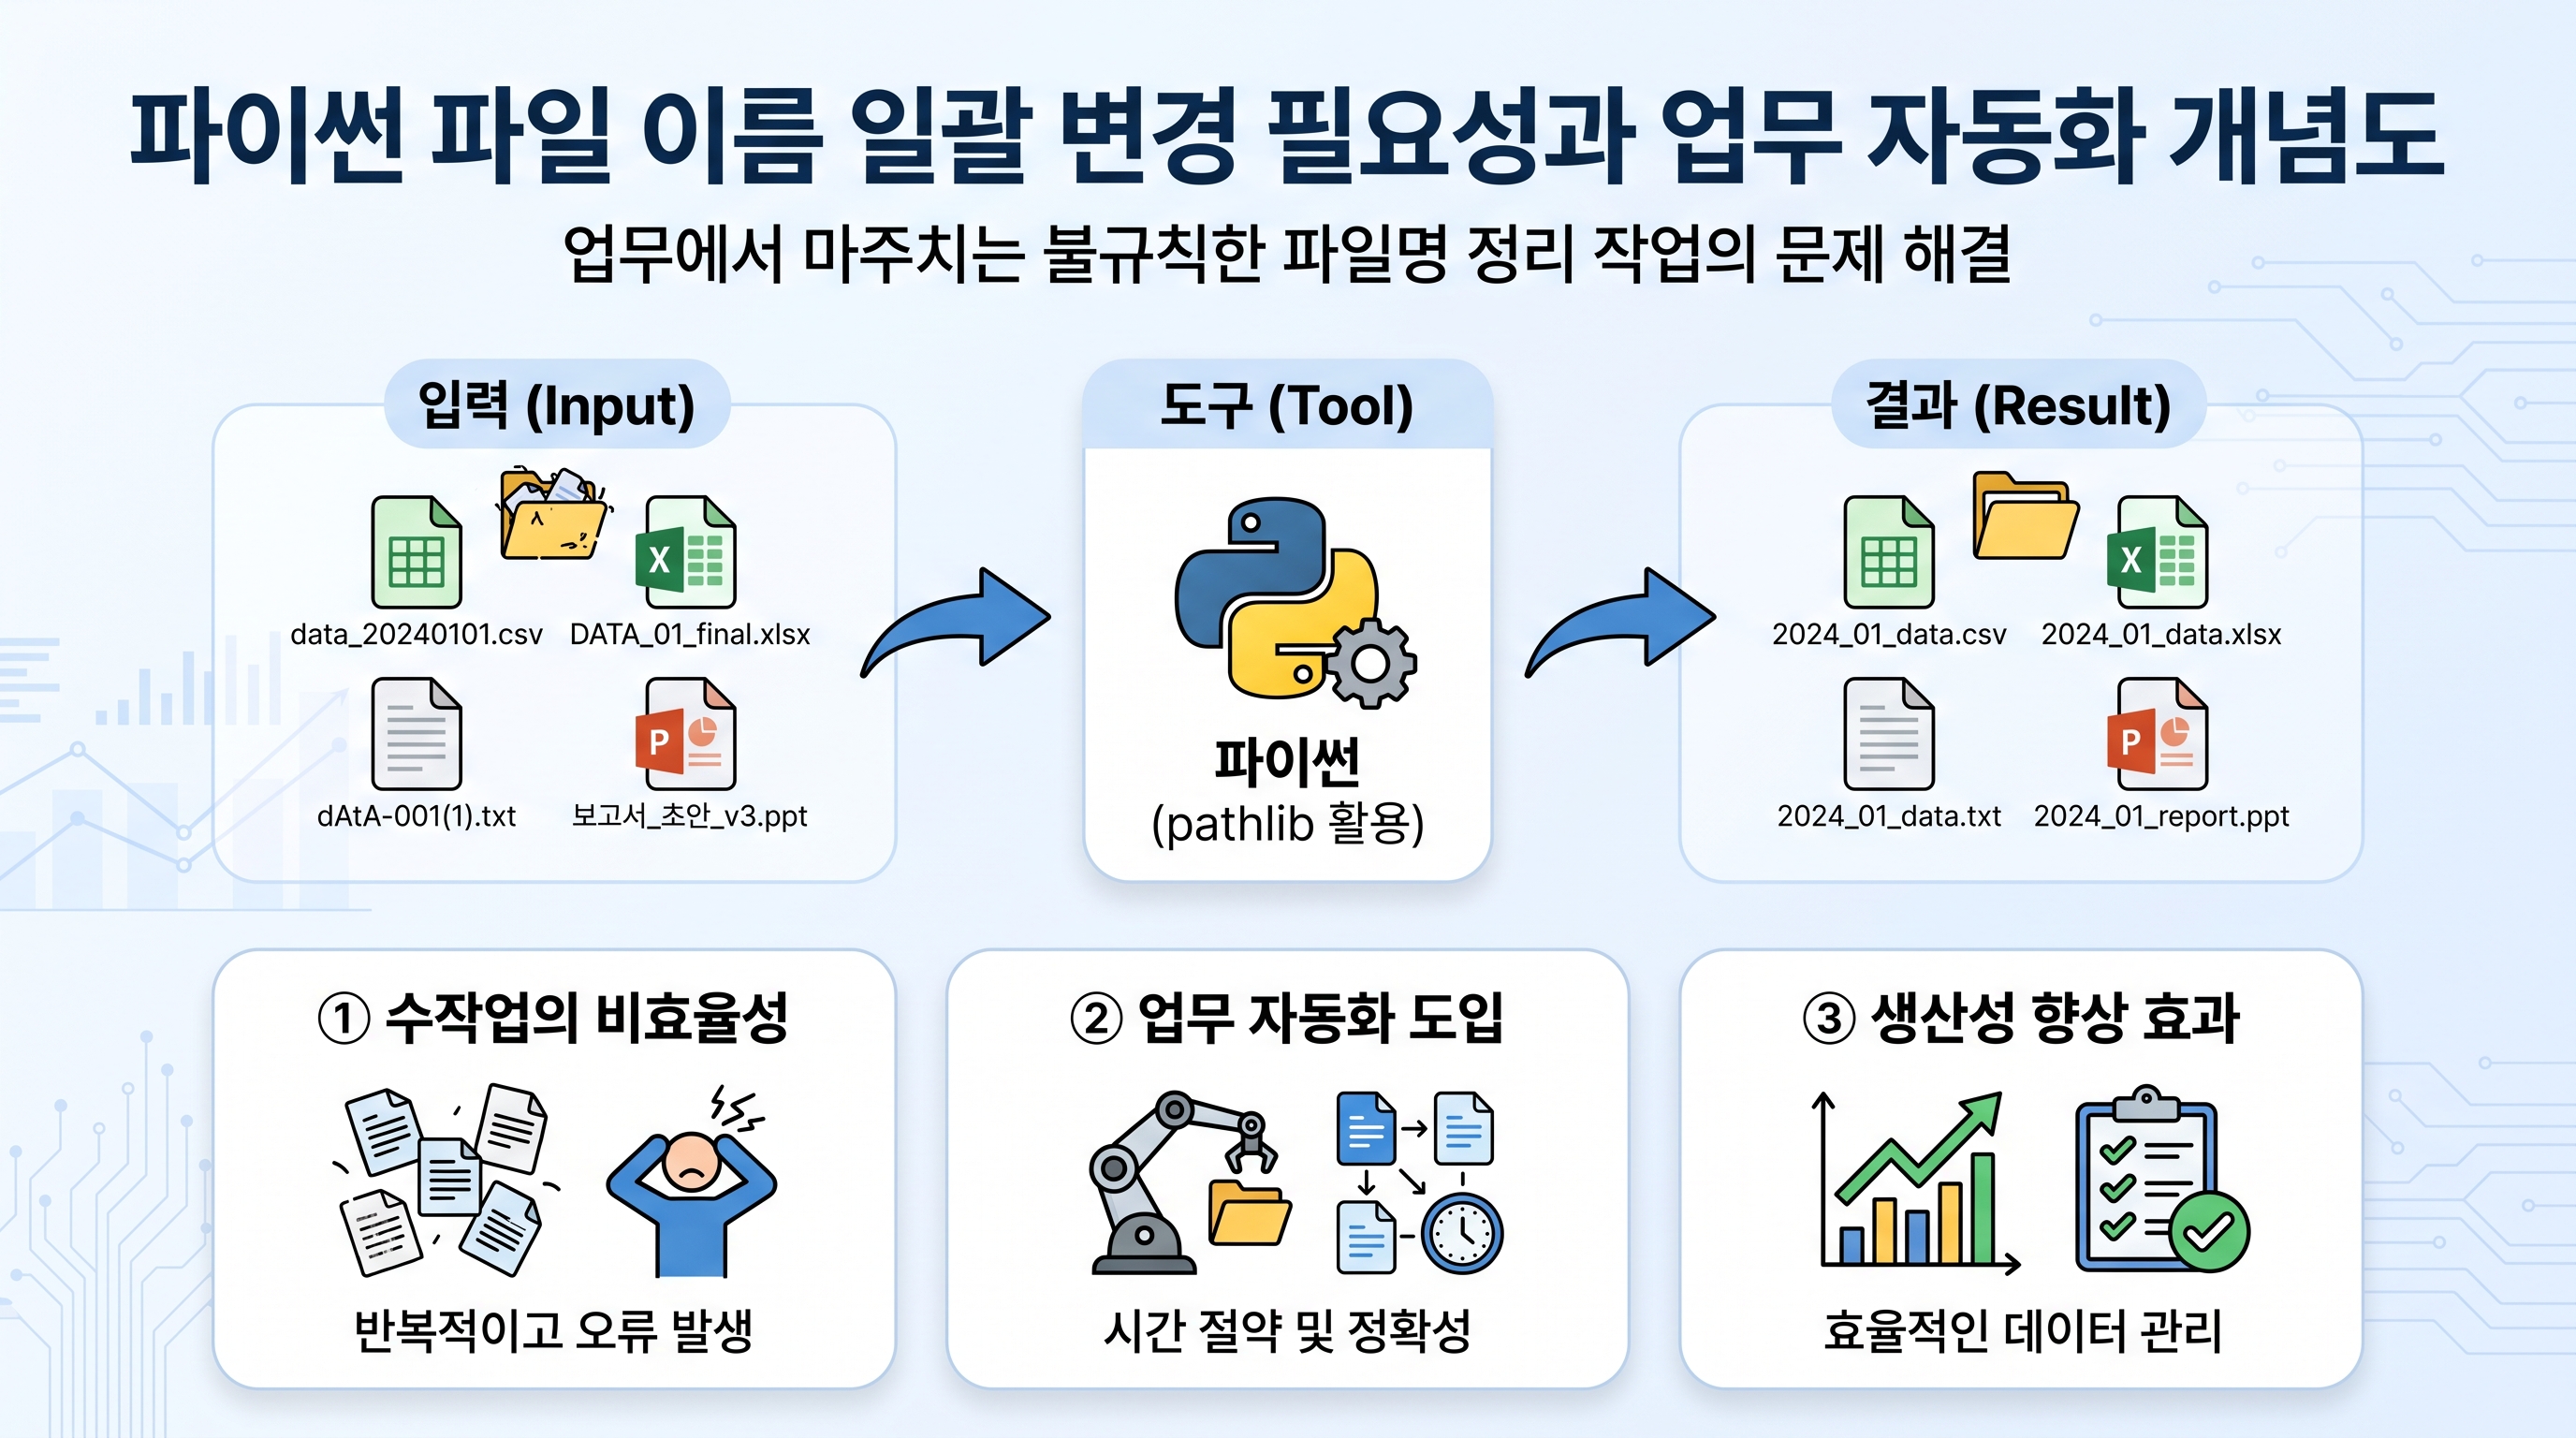
업무에서 마주치는 불규칙한 파일명 정리 작업의 번거로움
매달 정기적으로 취합하는 보고서나 영수증 스캔 파일, 사진 자료를 다루다 보면 파일명이 제각각으로 저장되어 정리가 곤란한 상황이 자주 발생합니다. 예를 들어 '2026_1월_결과.xlsx', '1월보고서_최종_수정.xlsx', 'result_january.xlsx'처럼 서로 다른 작성 규칙으로 저장된 파일이 수십 수백 개 쌓이면, 검색과 정렬이 불가능해져 업무 효율이 크게 떨어집니다. 이를 일일이 F2 키를 눌러 손으로 수정하는 작업은 많은 시간이 소모될 뿐만 아니라 입력 오타가 발생하기 쉽습니다.
이러한 단순 반복 작업을 프로그래밍으로 해결할 때 가장 중요한 목표는 안전성입니다. 파일명을 바꾸는 도중 파일 확장자가 잘려 나가 파일이 열리지 않거나, 동일한 이름이 생성되어 기존 데이터가 덮어씌워지는 사고를 사전에 차단해야 합니다. 파이썬 기본 표준 라이브러리만으로도 몇 줄의 간결한 스크립트를 작성하면, 파일명 변경 규칙을 구현할 수 있습니다. 원본 백업·대상 범위·미리보기·충돌 검수를 포함해야 하며 짧은 스크립트만으로 안전을 보장할 수는 없습니다.
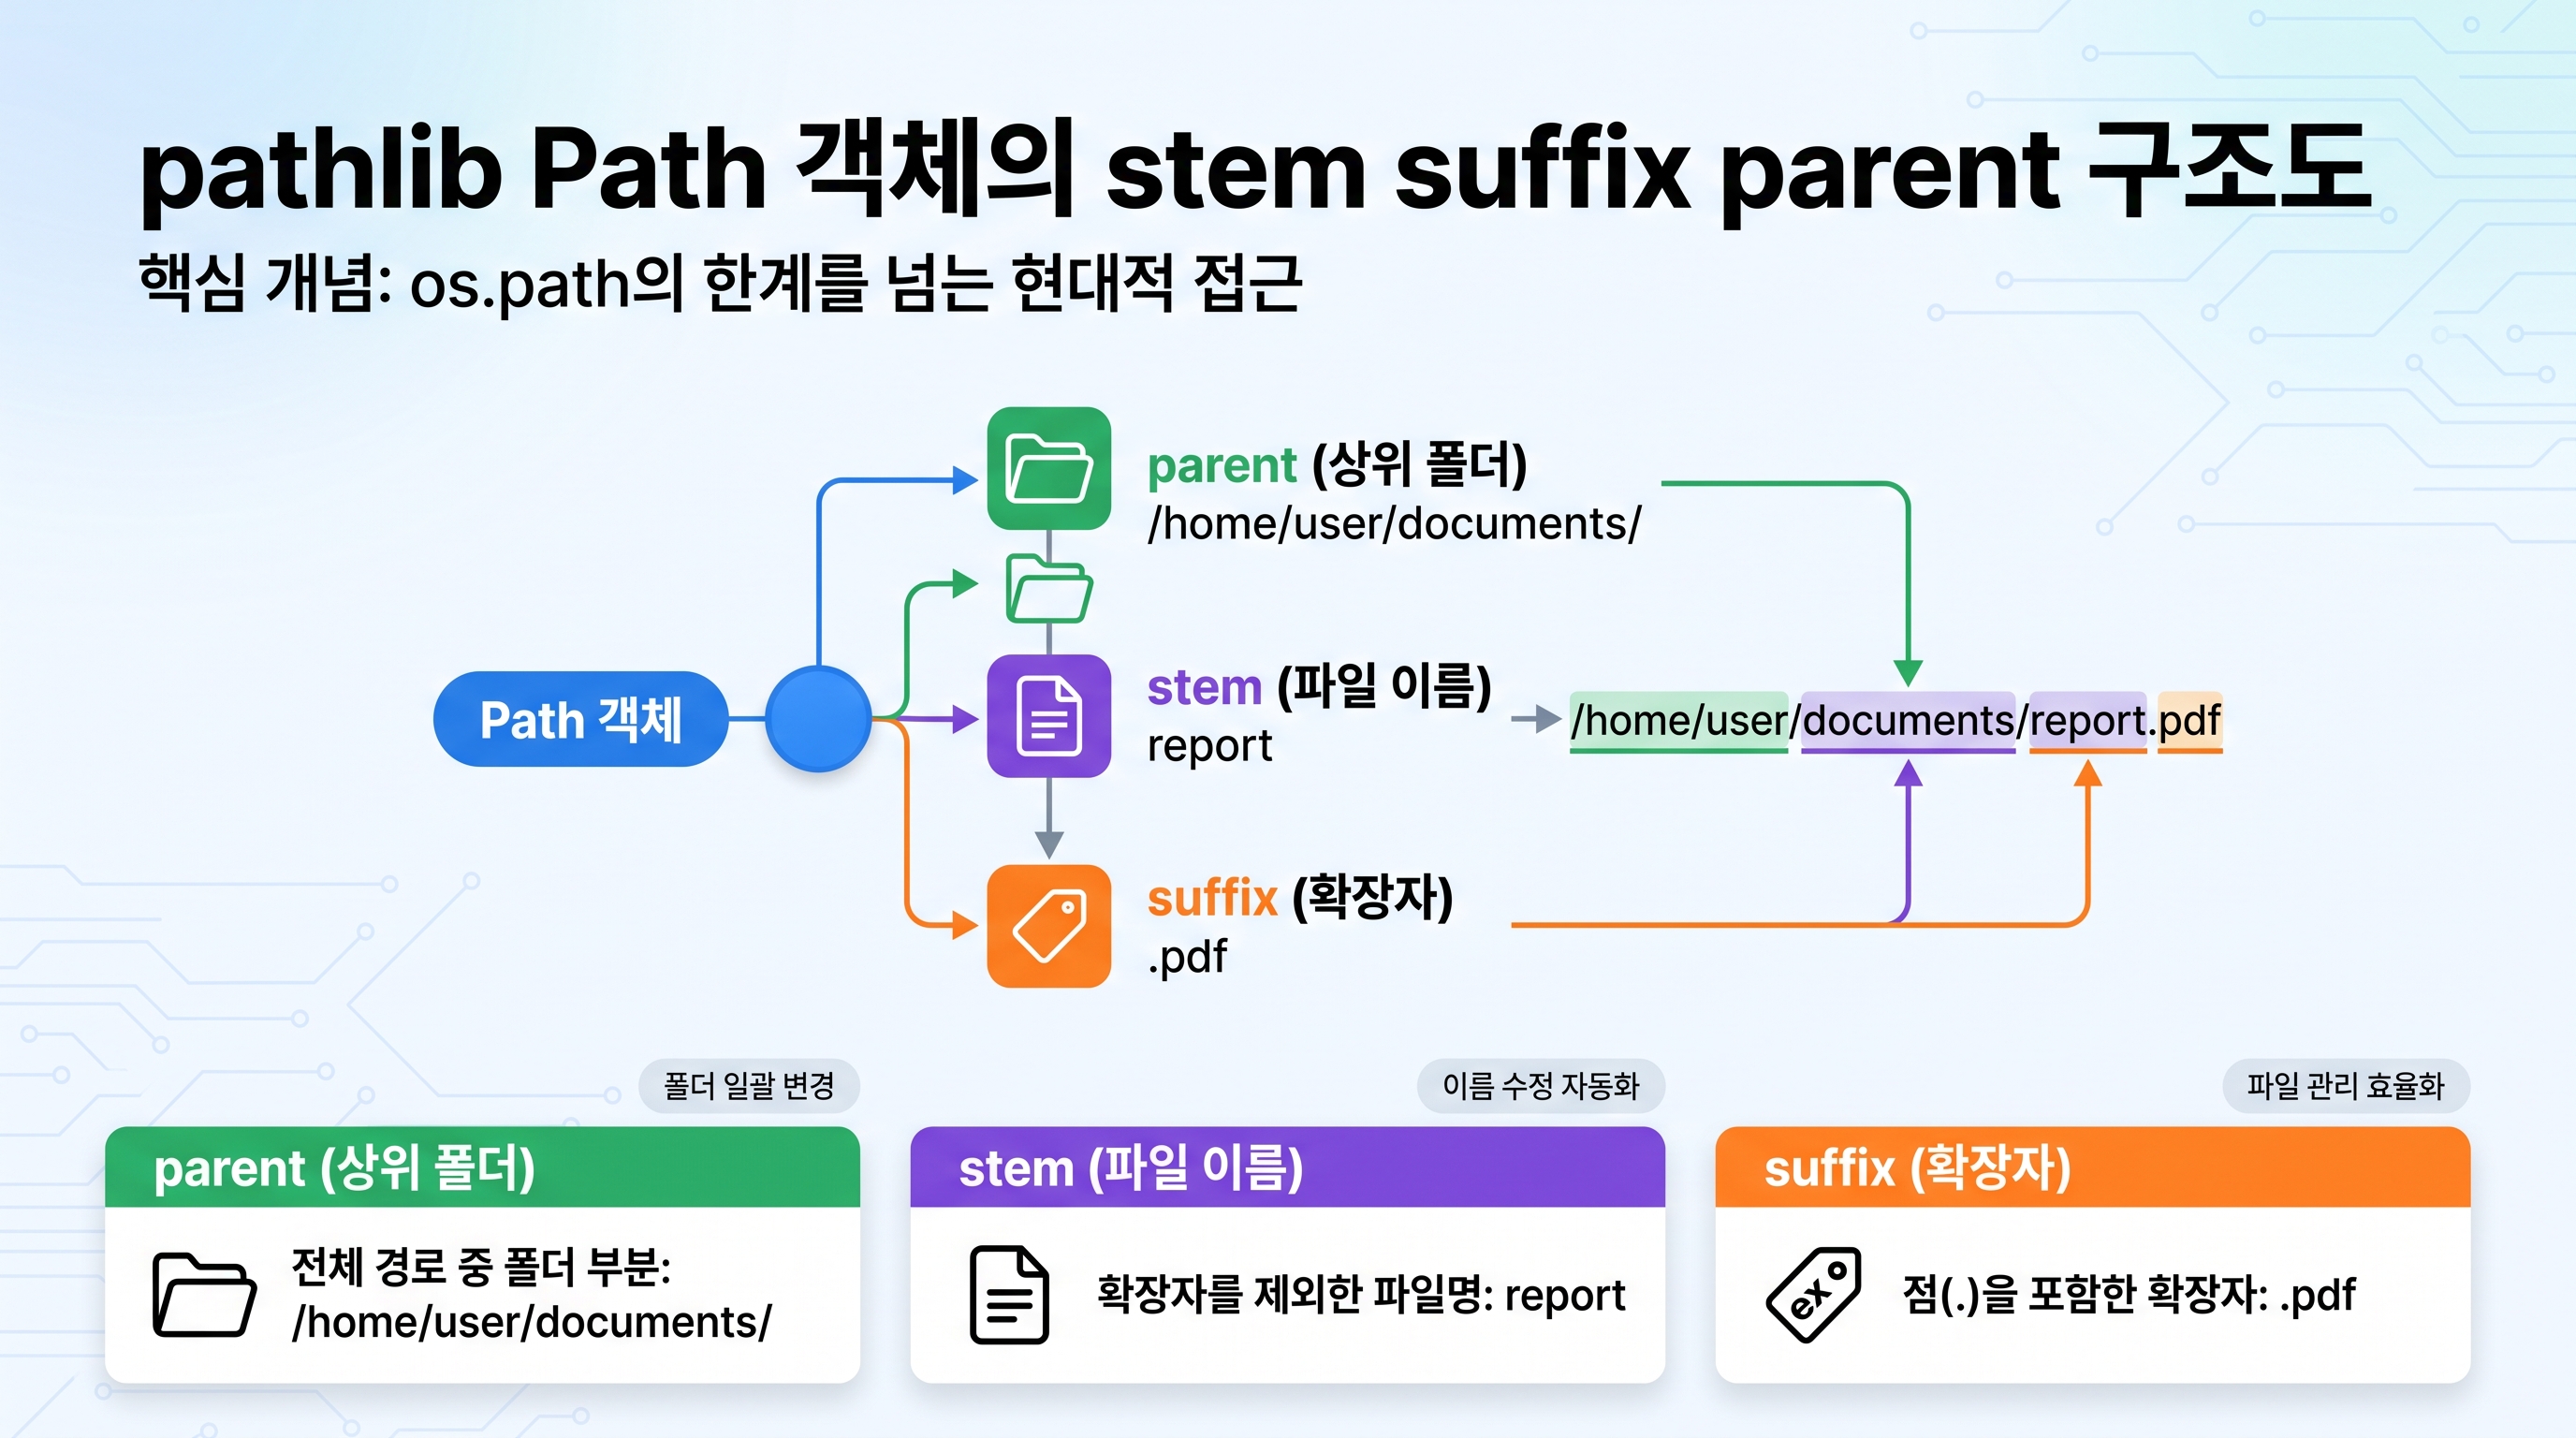
핵심 개념: os.path의 한계를 넘는 현대적인 pathlib의 객체 지향 구조
과거 파이썬 2 시절부터 많이 쓰이던 os.path 모듈은 파일 경로를 단순한 문자열로 취급했습니다. 문자열 연산 방식으로 경로를 다루면 슬래시(/)나 역슬래시(\) 같은 운영체제별 구분 기호 문제로 오류가 나기 쉬웠고, 확장자를 떼어내고 파일명을 조합하는 과정에서 코드가 복잡해졌습니다. 반면 파이썬 3.4부터 표준 라이브러리로 공식 도입된 pathlib 모듈은 경로를 하나의 똑똑한 'Path 객체'로 다룹니다.
pathlib의 핵심 강점은 파일 이름을 구성하는 요소를 직관적인 속성으로 분리해 제공한다는 점입니다. 예를 들어 'report.xlsx'라는 파일에서 순수 파일명인 'report'는 path.stem 속성으로, 점을 포함한 확장자인 '.xlsx'는 path.suffix 속성으로 바로 꺼내 쓸 수 있습니다. 또한 파이썬 3.9 이상에서 기본 지원되는 path.with_stem() 메서드를 사용하면 기존 확장자를 유지하면서 파일명 앞부분만 깔끔하게 새로운 이름으로 교체할 수 있어 파일명과 확장자를 구분하기 쉽습니다. 다중 확장자와 실제 이름 규칙은 별도로 검수합니다.
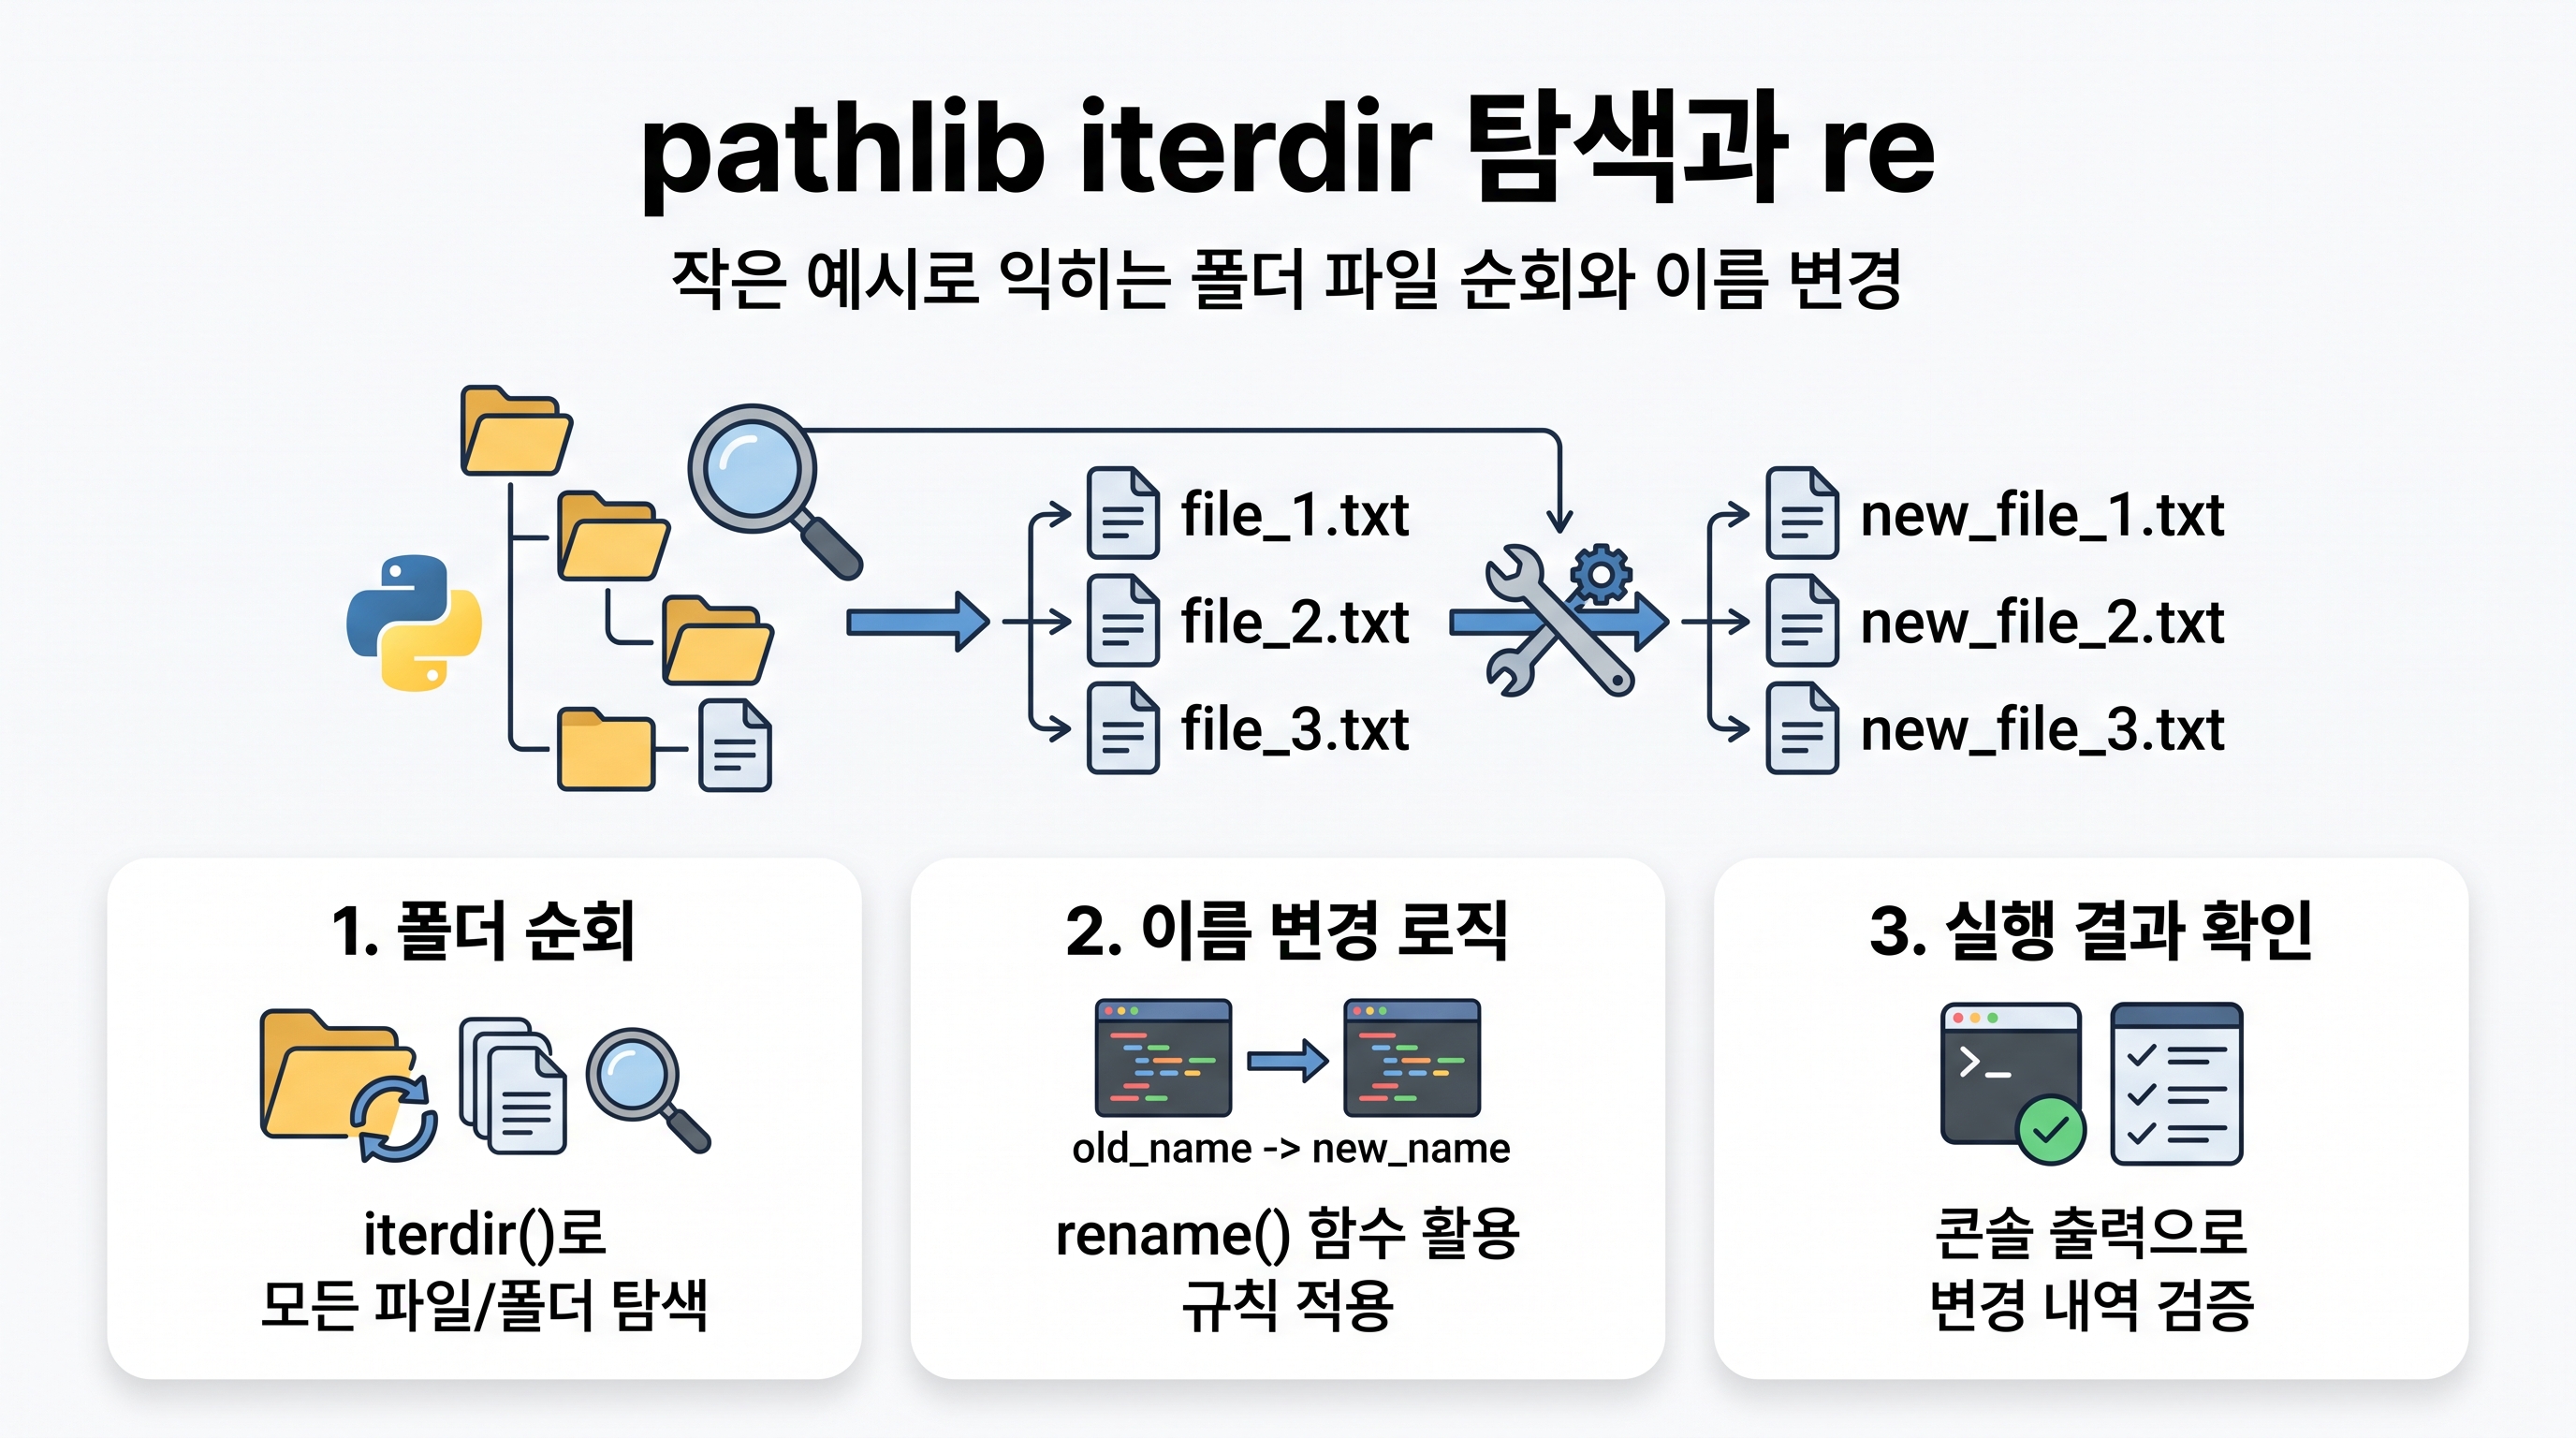
작은 예시로 익히는 폴더 파일 순회와 이름 변경 기본 패턴
가장 기초적인 실무 코드는 대상 디렉터리를 지정하고 그 안의 파일 목록을 순회하며 변경 대상 파일만 선별하는 것입니다. Path('대상폴더경로')로 객체를 생성한 뒤, iterdir() 메서드를 호출하면 폴더 내부의 모든 항목을 하나씩 순회할 수 있습니다. 이때 하위 폴더까지 실수로 이름이 바뀌지 않도록 path.is_file() 검사를 수행해 순수 파일만 걸러내는 방어 코드가 반드시 포함되어야 합니다.
새로운 파일명을 즉시 적용하기 전에 print() 함수로 기존 이름과 변경될 이름을 미리 출력해보는 'Dry-run(가상 실행)' 단계를 거치는 것이 안전합니다. 예를 들어 'for file_path in target_dir.iterdir(): if file_path.is_file(): new_name = f'2026_{file_path.stem}{file_path.suffix}'; print(f'{file_path.name} -> {new_name}')' 형태로 콘솔에서 먼저 확인하는 방식입니다. 실제 이름 변경은 검증이 끝난 후 file_path.rename(file_path.with_name(new_name)) 구문을 실행하여 마무리합니다.
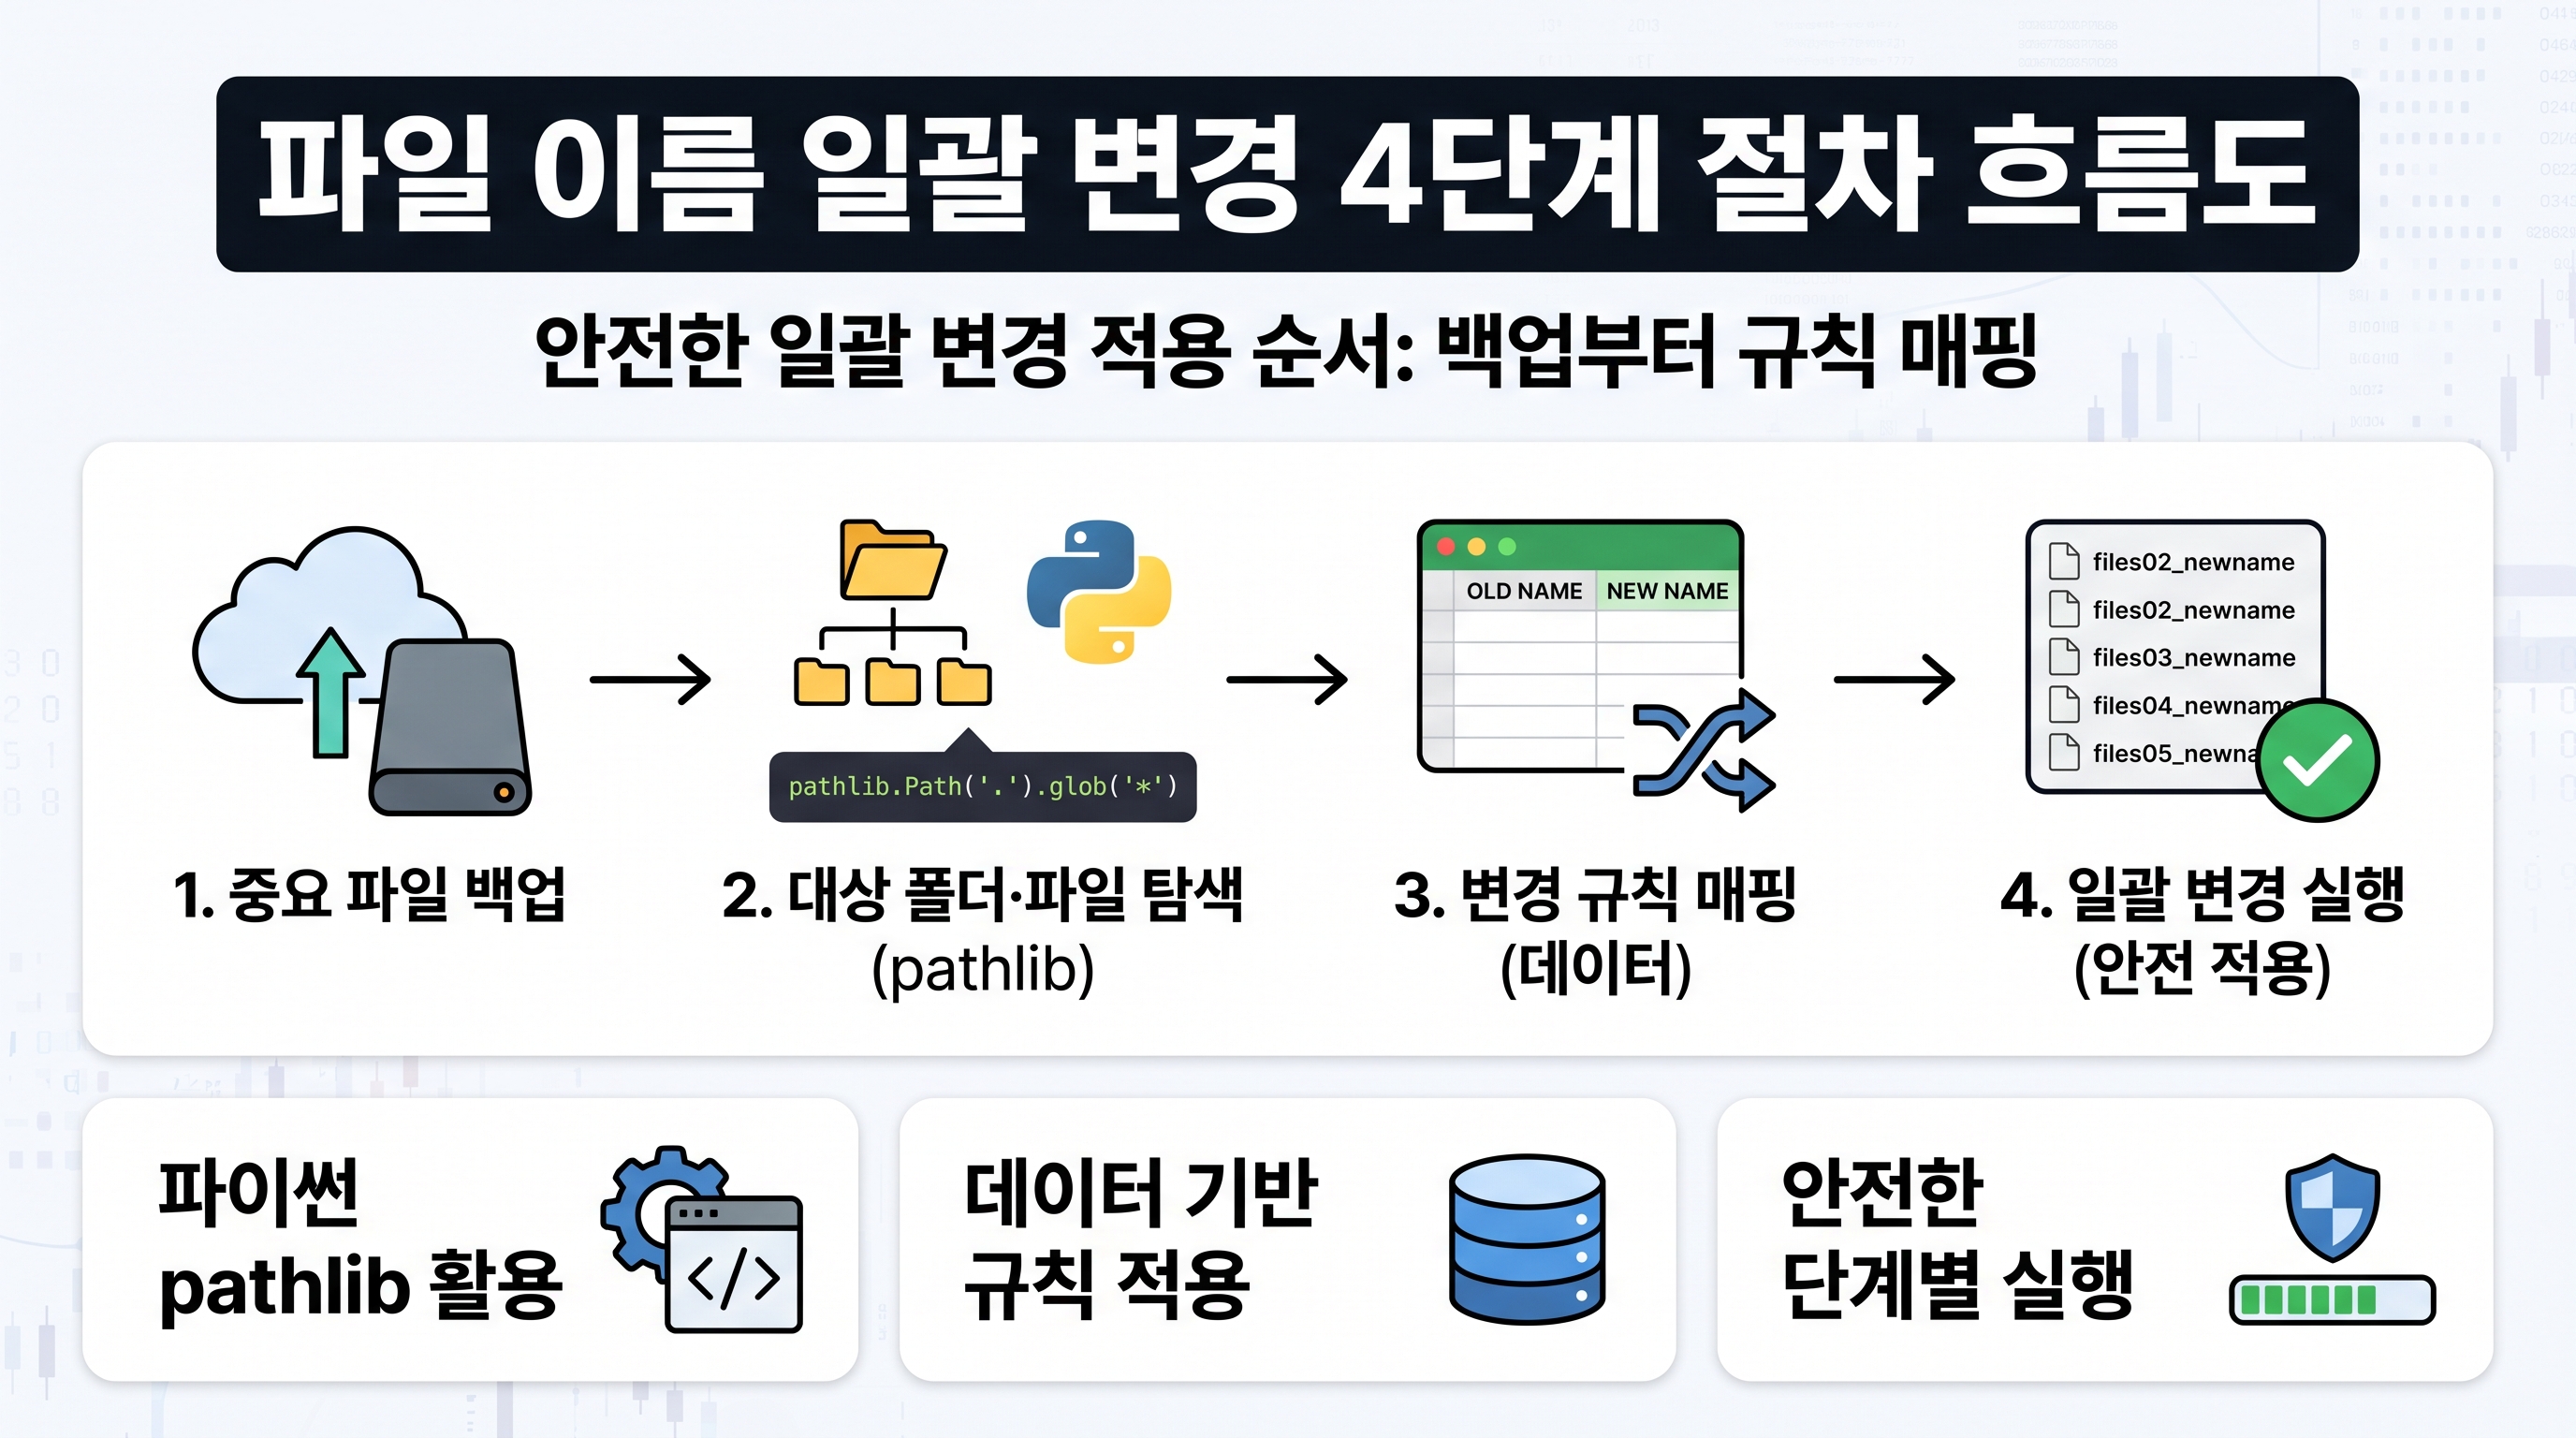
안전한 일괄 변경 적용 순서: 백업부터 규칙 매핑까지 4단계 절차
실제 업무 파일에 일괄 변경 스크립트를 적용할 때는 반드시 정형화된 4단계 절차를 지켜야 합니다. 첫 번째 단계는 원본 폴더 백업입니다. 스크립트 실행 오류 시 원상 복구가 불가능한 문제를 방지하기 위해 작업 대상 폴더를 다른 위치에 복사해 둡니다. 두 번째 단계는 glob() 메서드를 사용해 특정 확장자(.xlsx, .csv, .pdf 등)만 정확히 수집하도록 파일 탐색 범위를 한정하는 것입니다.
세 번째 단계는 규칙 매핑 함수를 정의하여 불필요한 공백 제거, 특수문자 치환, 일련번호 부여 또는 접두사(Prefix) 부착 로직을 작성하는 것입니다. 네 번째 단계는 대상 경로에 이미 동일한 이름의 파일이 존재하는지 target_path.exists() 조건문으로 확인한 뒤 rename()을 실행하는 것입니다. 이미 같은 이름이 있으면 변경을 멈추거나 별도 검토 대상으로 남깁니다. Path.rename은 운영체제에 따라 기존 대상 처리 방식이 달라질 수 있으므로 exists 확인만으로 덮어쓰기 방지를 보장하지 않습니다. 복사본에서 충돌·잠금·동시 변경 표본을 확인하고 변경 전후 대응표와 백업을 보존합니다.
이해 확인: 실무에서 자주 겪는 예외 상황과 체크포인트
pathlib을 활용한 파일명 일괄 변경을 완벽히 소화했는지 점검하기 위해 실무에서 흔히 마주치는 세 가지 예외 상황을 짚어보아야 합니다. 첫째, 윈도우 환경에서는 파일명에 대소문자를 구분하지 않으므로 'data.txt'를 'DATA.txt'로 단순히 rename() 하려 할 때 예외가 발생하거나 무시될 수 있습니다. 이 경우 임시 파일명을 거쳐 2단계로 변경하는 우회 절차가 필요합니다.
둘째, 열려 있는 엑셀 파일이나 한글 문서는 운영체제 레벨에서 파일 잠금(Locking)이 걸려 PermissionError가 발생합니다. 스크립트 실행 전 관련 프로그램을 모두 닫았는지 확인하고, try-except 블록으로 잠긴 파일이 있더라도 전체 프로세스가 중단되지 않고 건너뛰며 로그를 남기도록 설계해야 합니다. 이러한 예외 처리 패턴까지 익혀두면 파일 수·저장 위치·권한·잠금 상태에 맞춰 수행 시간과 예외를 확인할 수 있습니다.

파일 업무 자동화의 결과물 검수
허구 R001과 R002를 사용해 원본 이름·변경 예정 이름·결과·오류 단계를 대응표로 남기는 예입니다. 읽기·미리보기와 실제 이동·변경을 구분하고, 정상 파일·동명 충돌·열린 파일·확인되지 않은 경로 표본을 준비합니다. 실제 사용자 원본에 적용하기 전에 범위·백업·되돌릴 방법을 확인합니다.
