1대N 테이블 조인 SUM 중복 집계 오류 원인 분석과 올바른 쿼리 해결 방법
1대N 관계를 가진 테이블을 단순 JOIN 후 SUM 집계를 수행하면 기준 테이블의 수치가 N배로 중복 계산되는 오류가 발생합니다. 본 글에서는 증상 재현부터 서브쿼리 사전 집계 해결법과 재발 방지 수칙까지 단계별로 안내합니다.
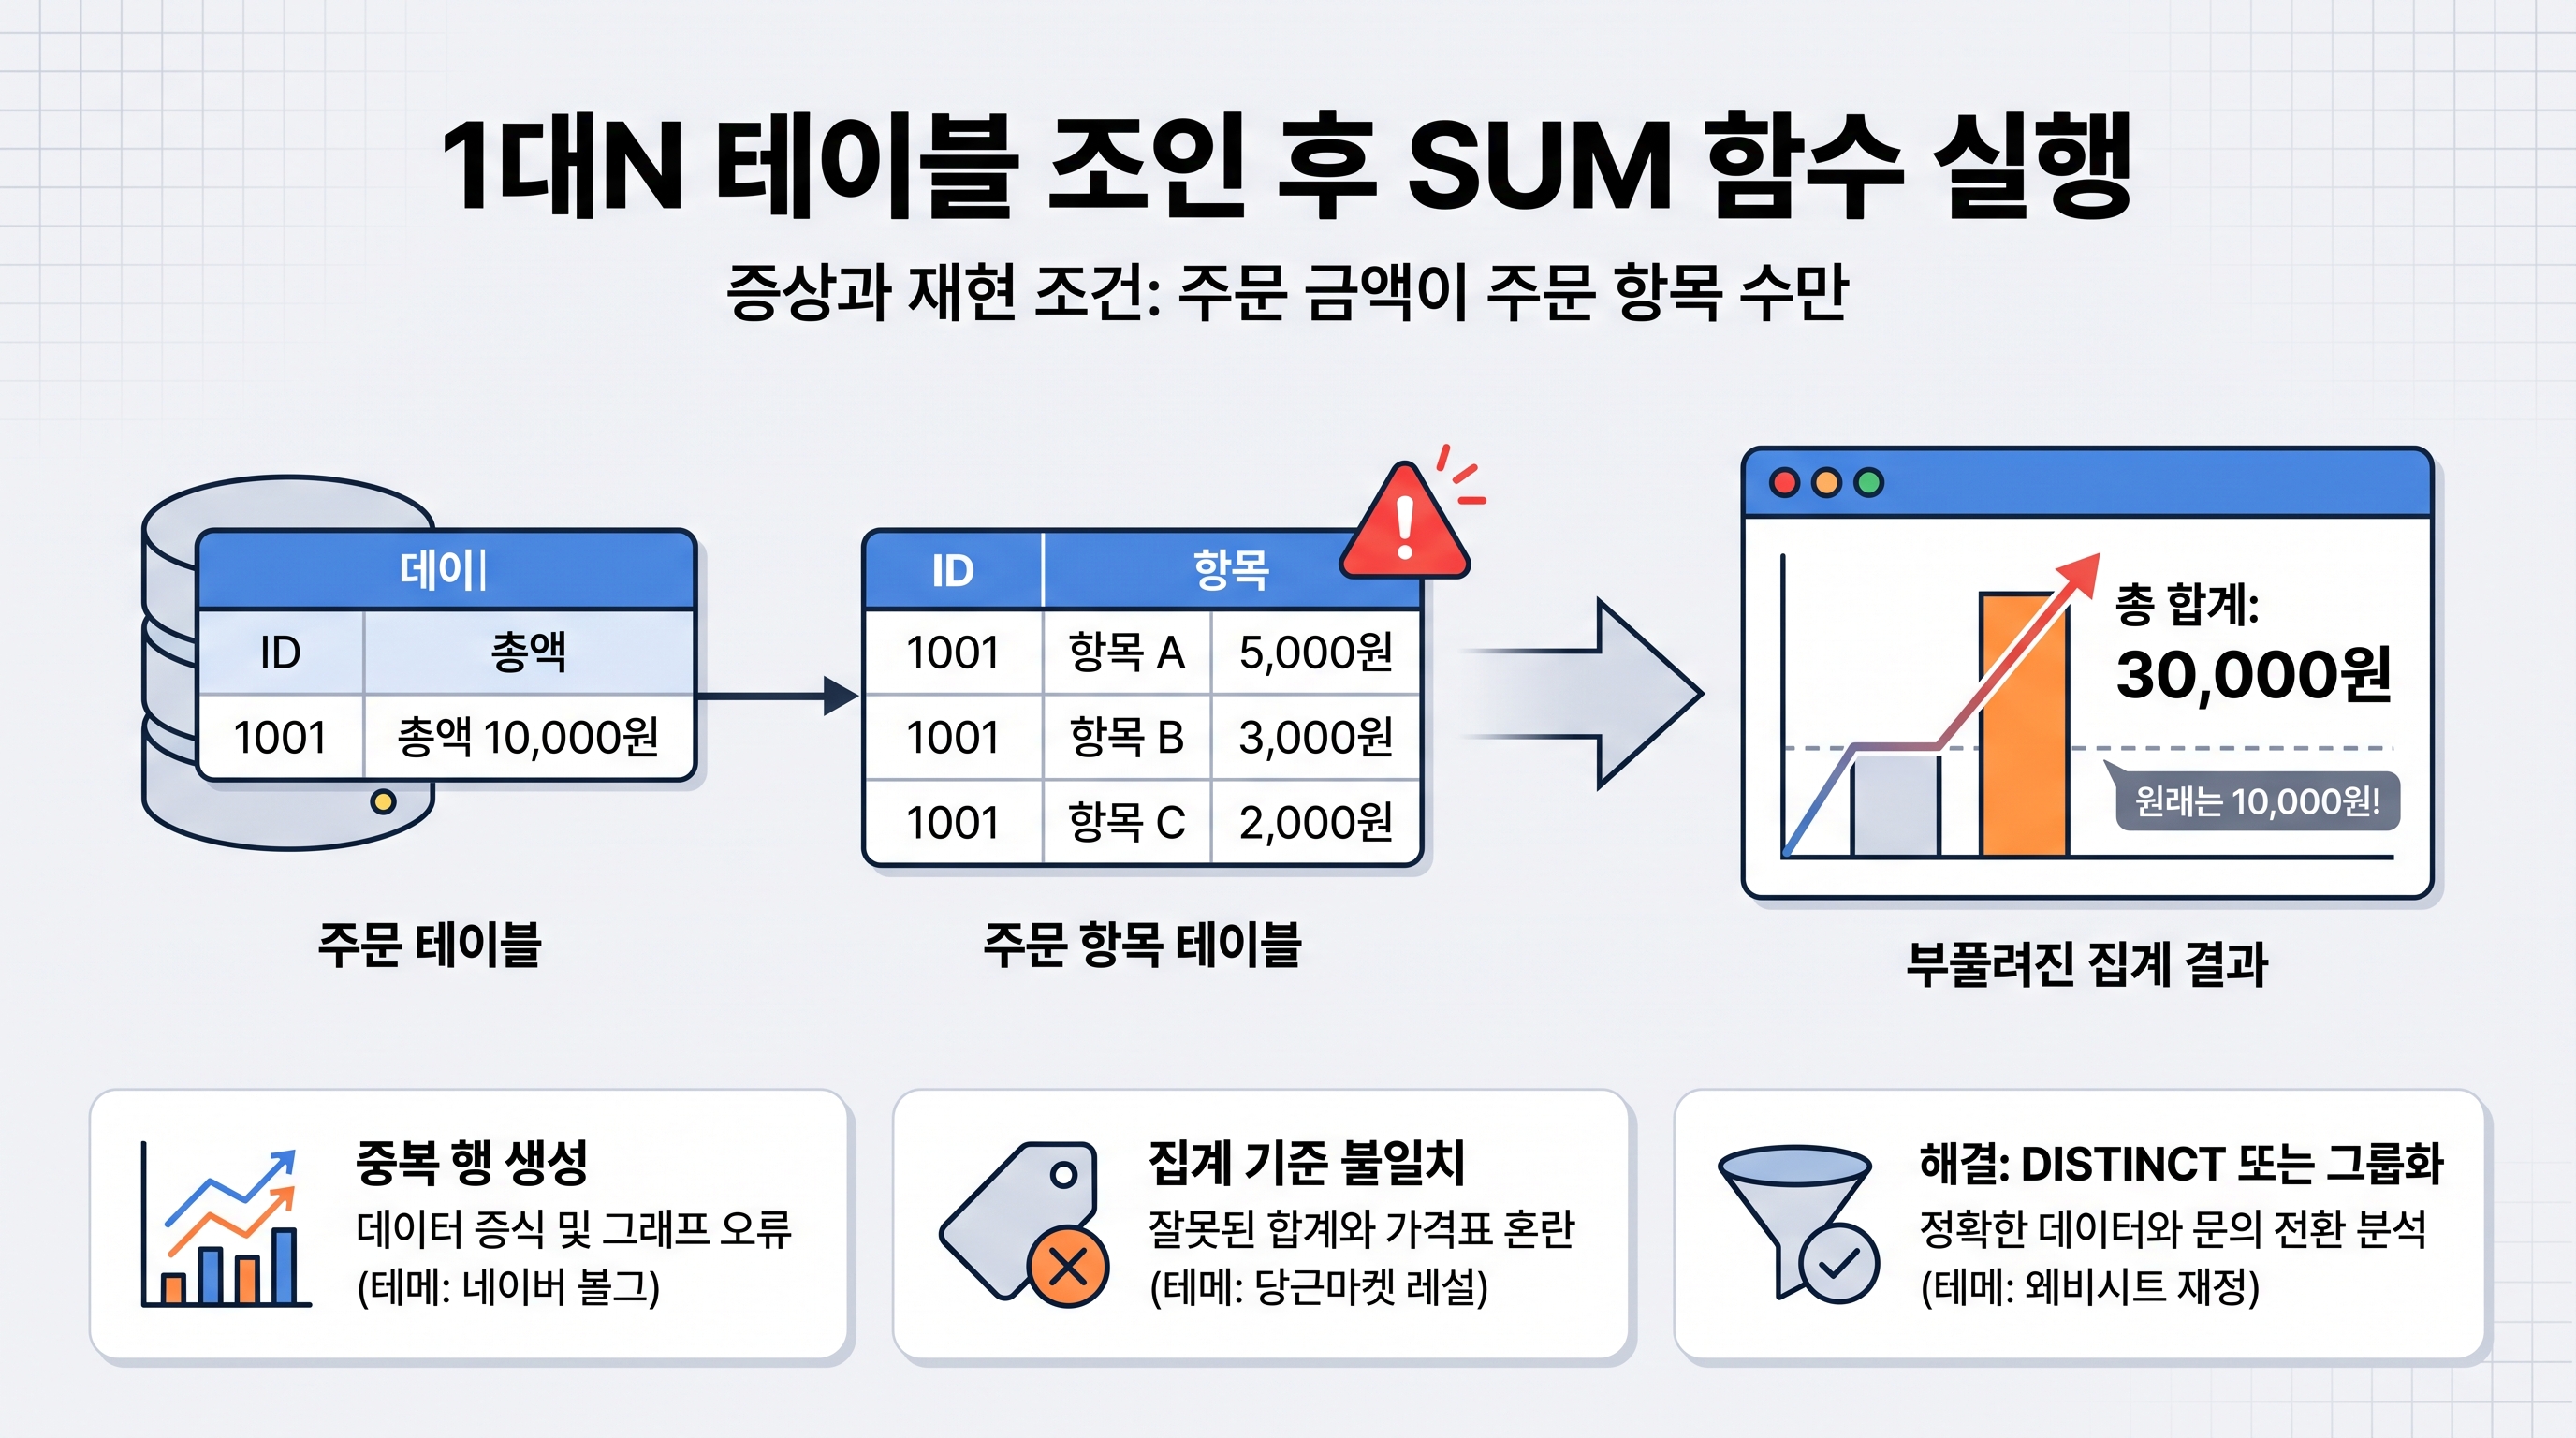
증상과 재현 조건: 주문 금액이 주문 항목 수만큼 곱해져 계산되는 현상
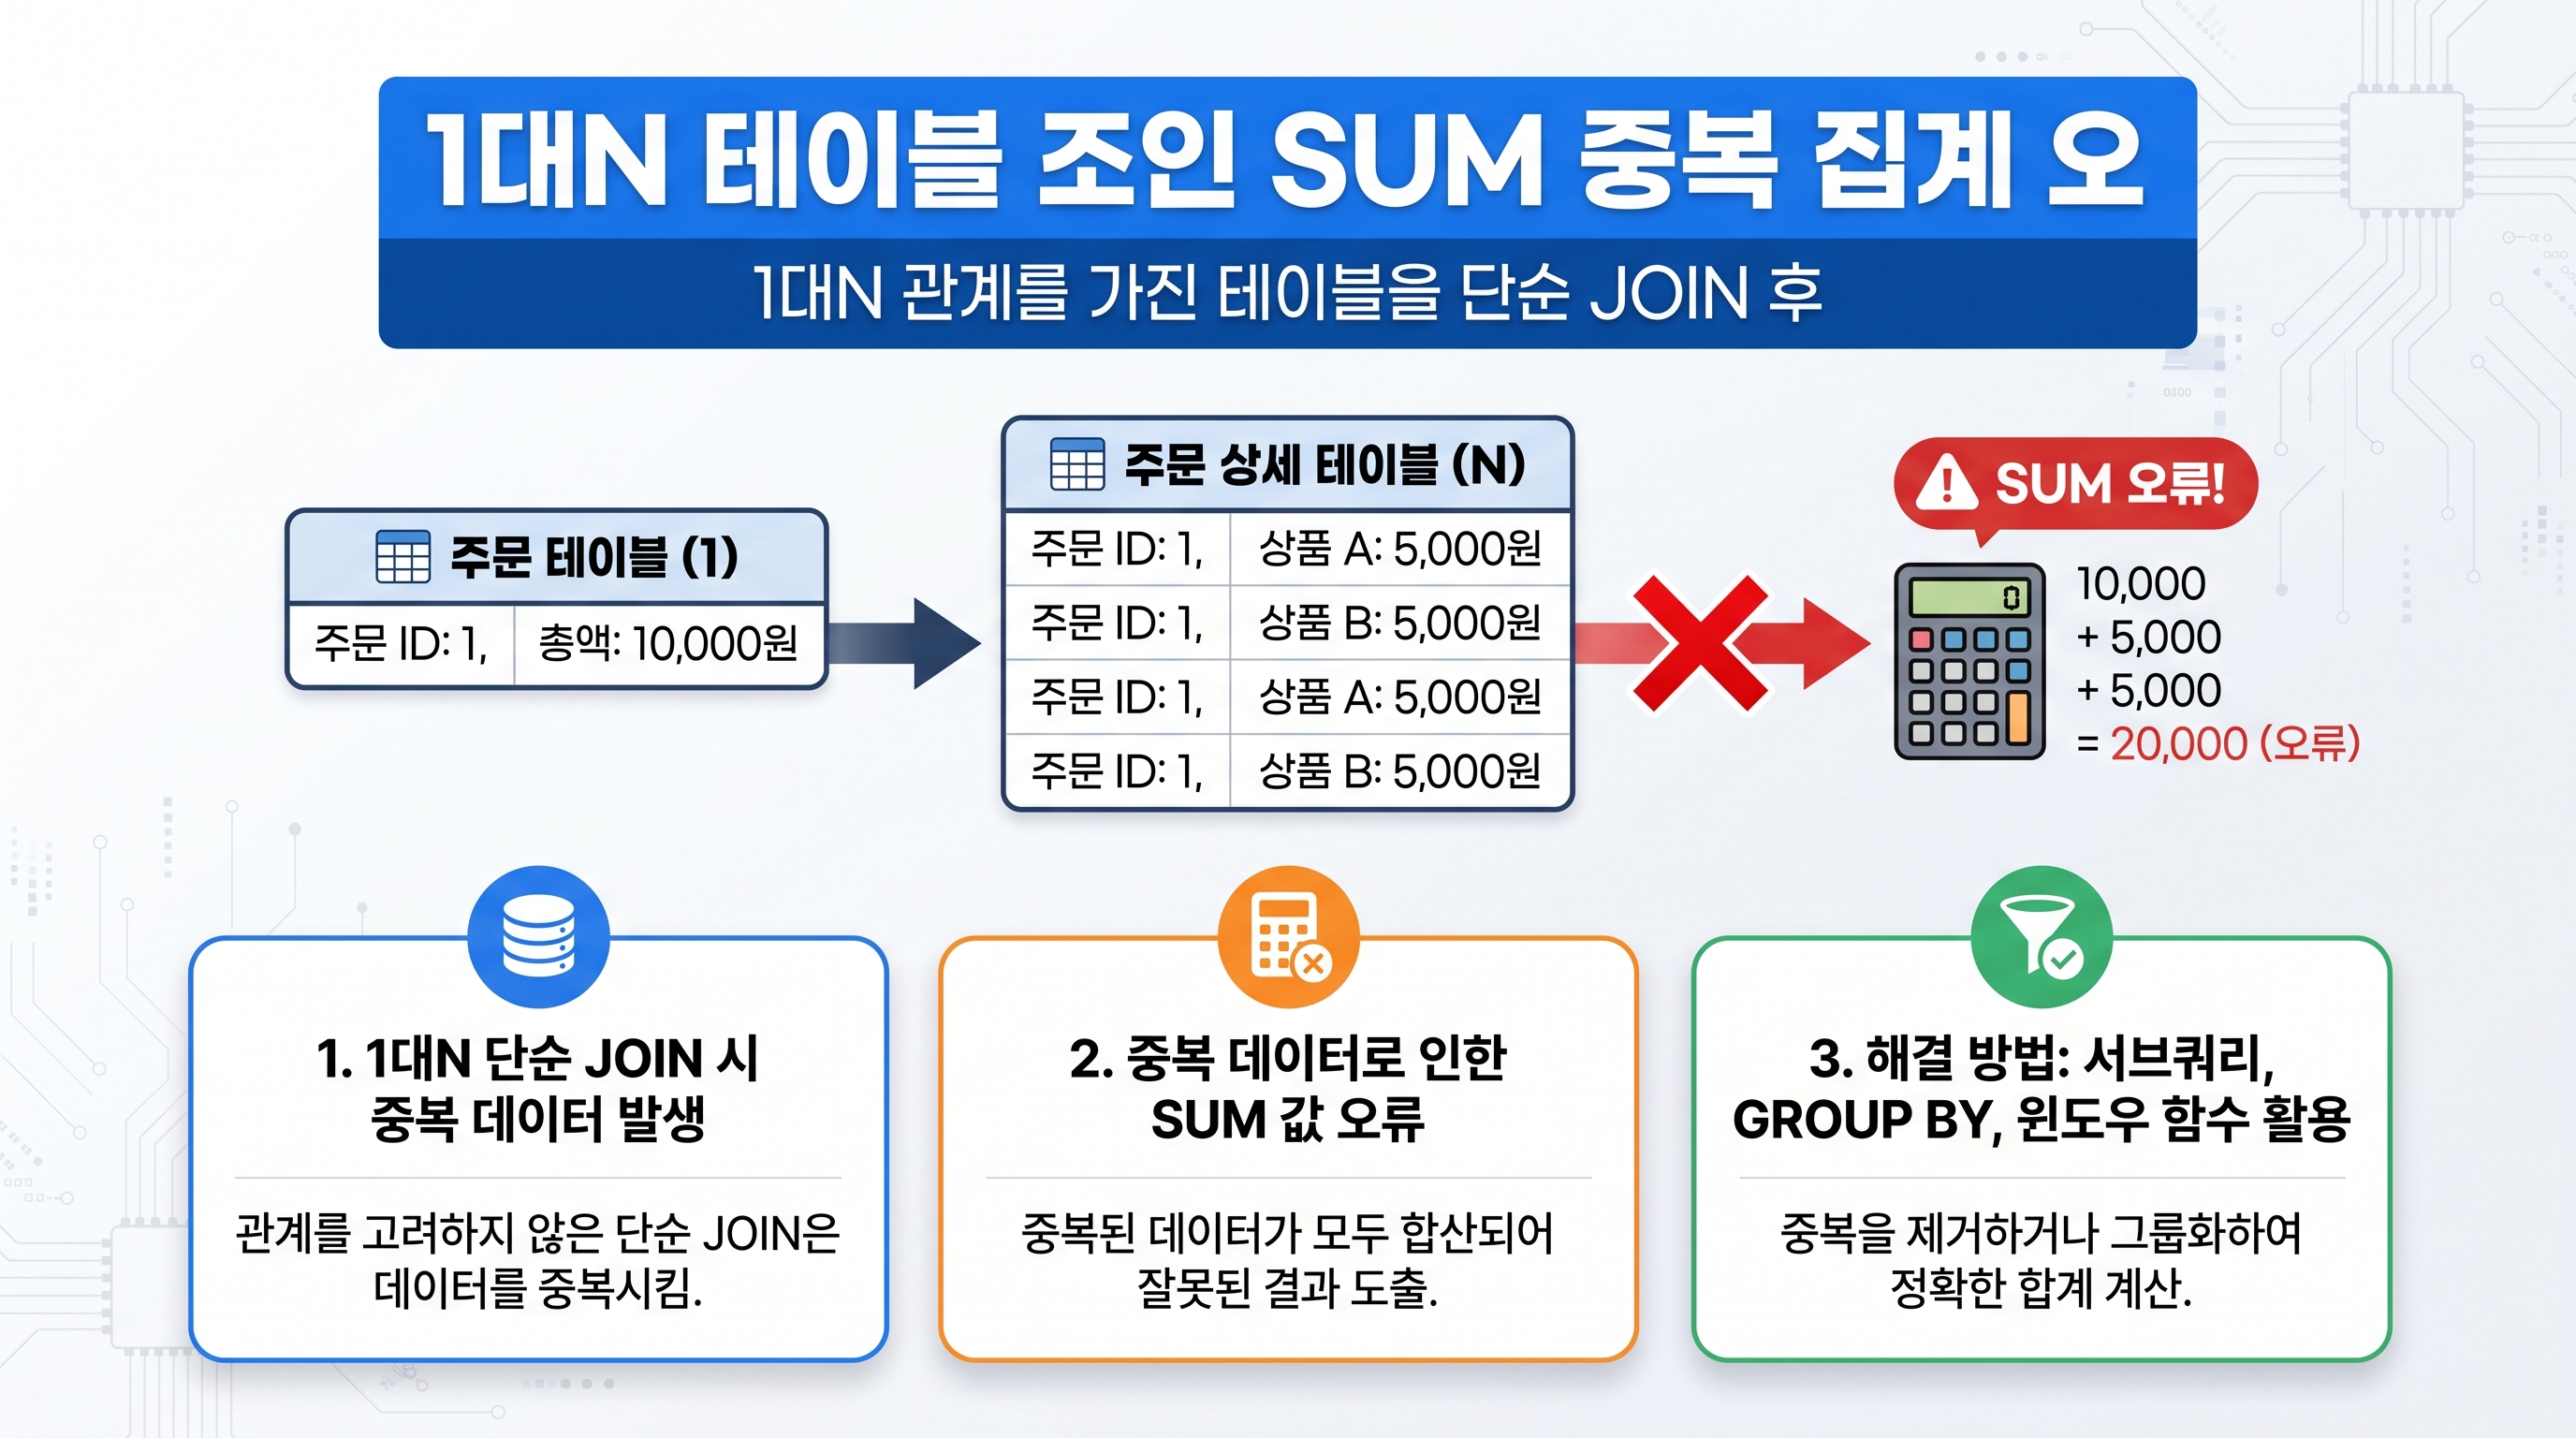
관계형 데이터베이스를 다룰 때 가장 흔하게 마주치는 집계 오류 중 하나는 부모-자식 관계에 놓인 두 테이블을 JOIN한 뒤 SUM 함수를 사용할 때 발생합니다. 예를 들어 쇼핑몰 시스템에서 한 건의 '주문(orders)' 테이블과 이에 딸린 다수의 '주문 품목(order_items)' 테이블이 존재하는 상황을 가정해보겠습니다. 관리자 대시보드에서 특정 회원의 총 주문 금액과 총 구매 수량을 한 화면에 보여주기 위해 두 테이블을 `order_id` 기준으로 조인하고 SUM(orders.total_amount)와 SUM(order_items.quantity)를 동시에 조회하는 쿼리를 실행합니다.
이때 기대한 결과는 orders 테이블에 기록된 실제 결제 금액이지만, 실제 쿼리 결과에는 실제 결제 금액의 2배, 3배에 달하는 비정상적으로 부풀려진 금액이 반환됩니다. 주문 1건에 상품 품목이 3개 연결되어 있다면 주문 금액이 정확히 3번 중복 합산되는 증상이 나타나는 것입니다. 초기 테스트 단계에서 주문당 품목이 1건뿐인 단일 데이터로만 검증했을 때는 정상처럼 보이다가, 실제 사용자가 다수의 품목을 장바구니에 담아 결제하면서부터 데이터 왜곡 현상이 본격적으로 드러납니다.
가능한 원인: 관계형 조인의 카디널리티 증가와 행 복제 메커니즘
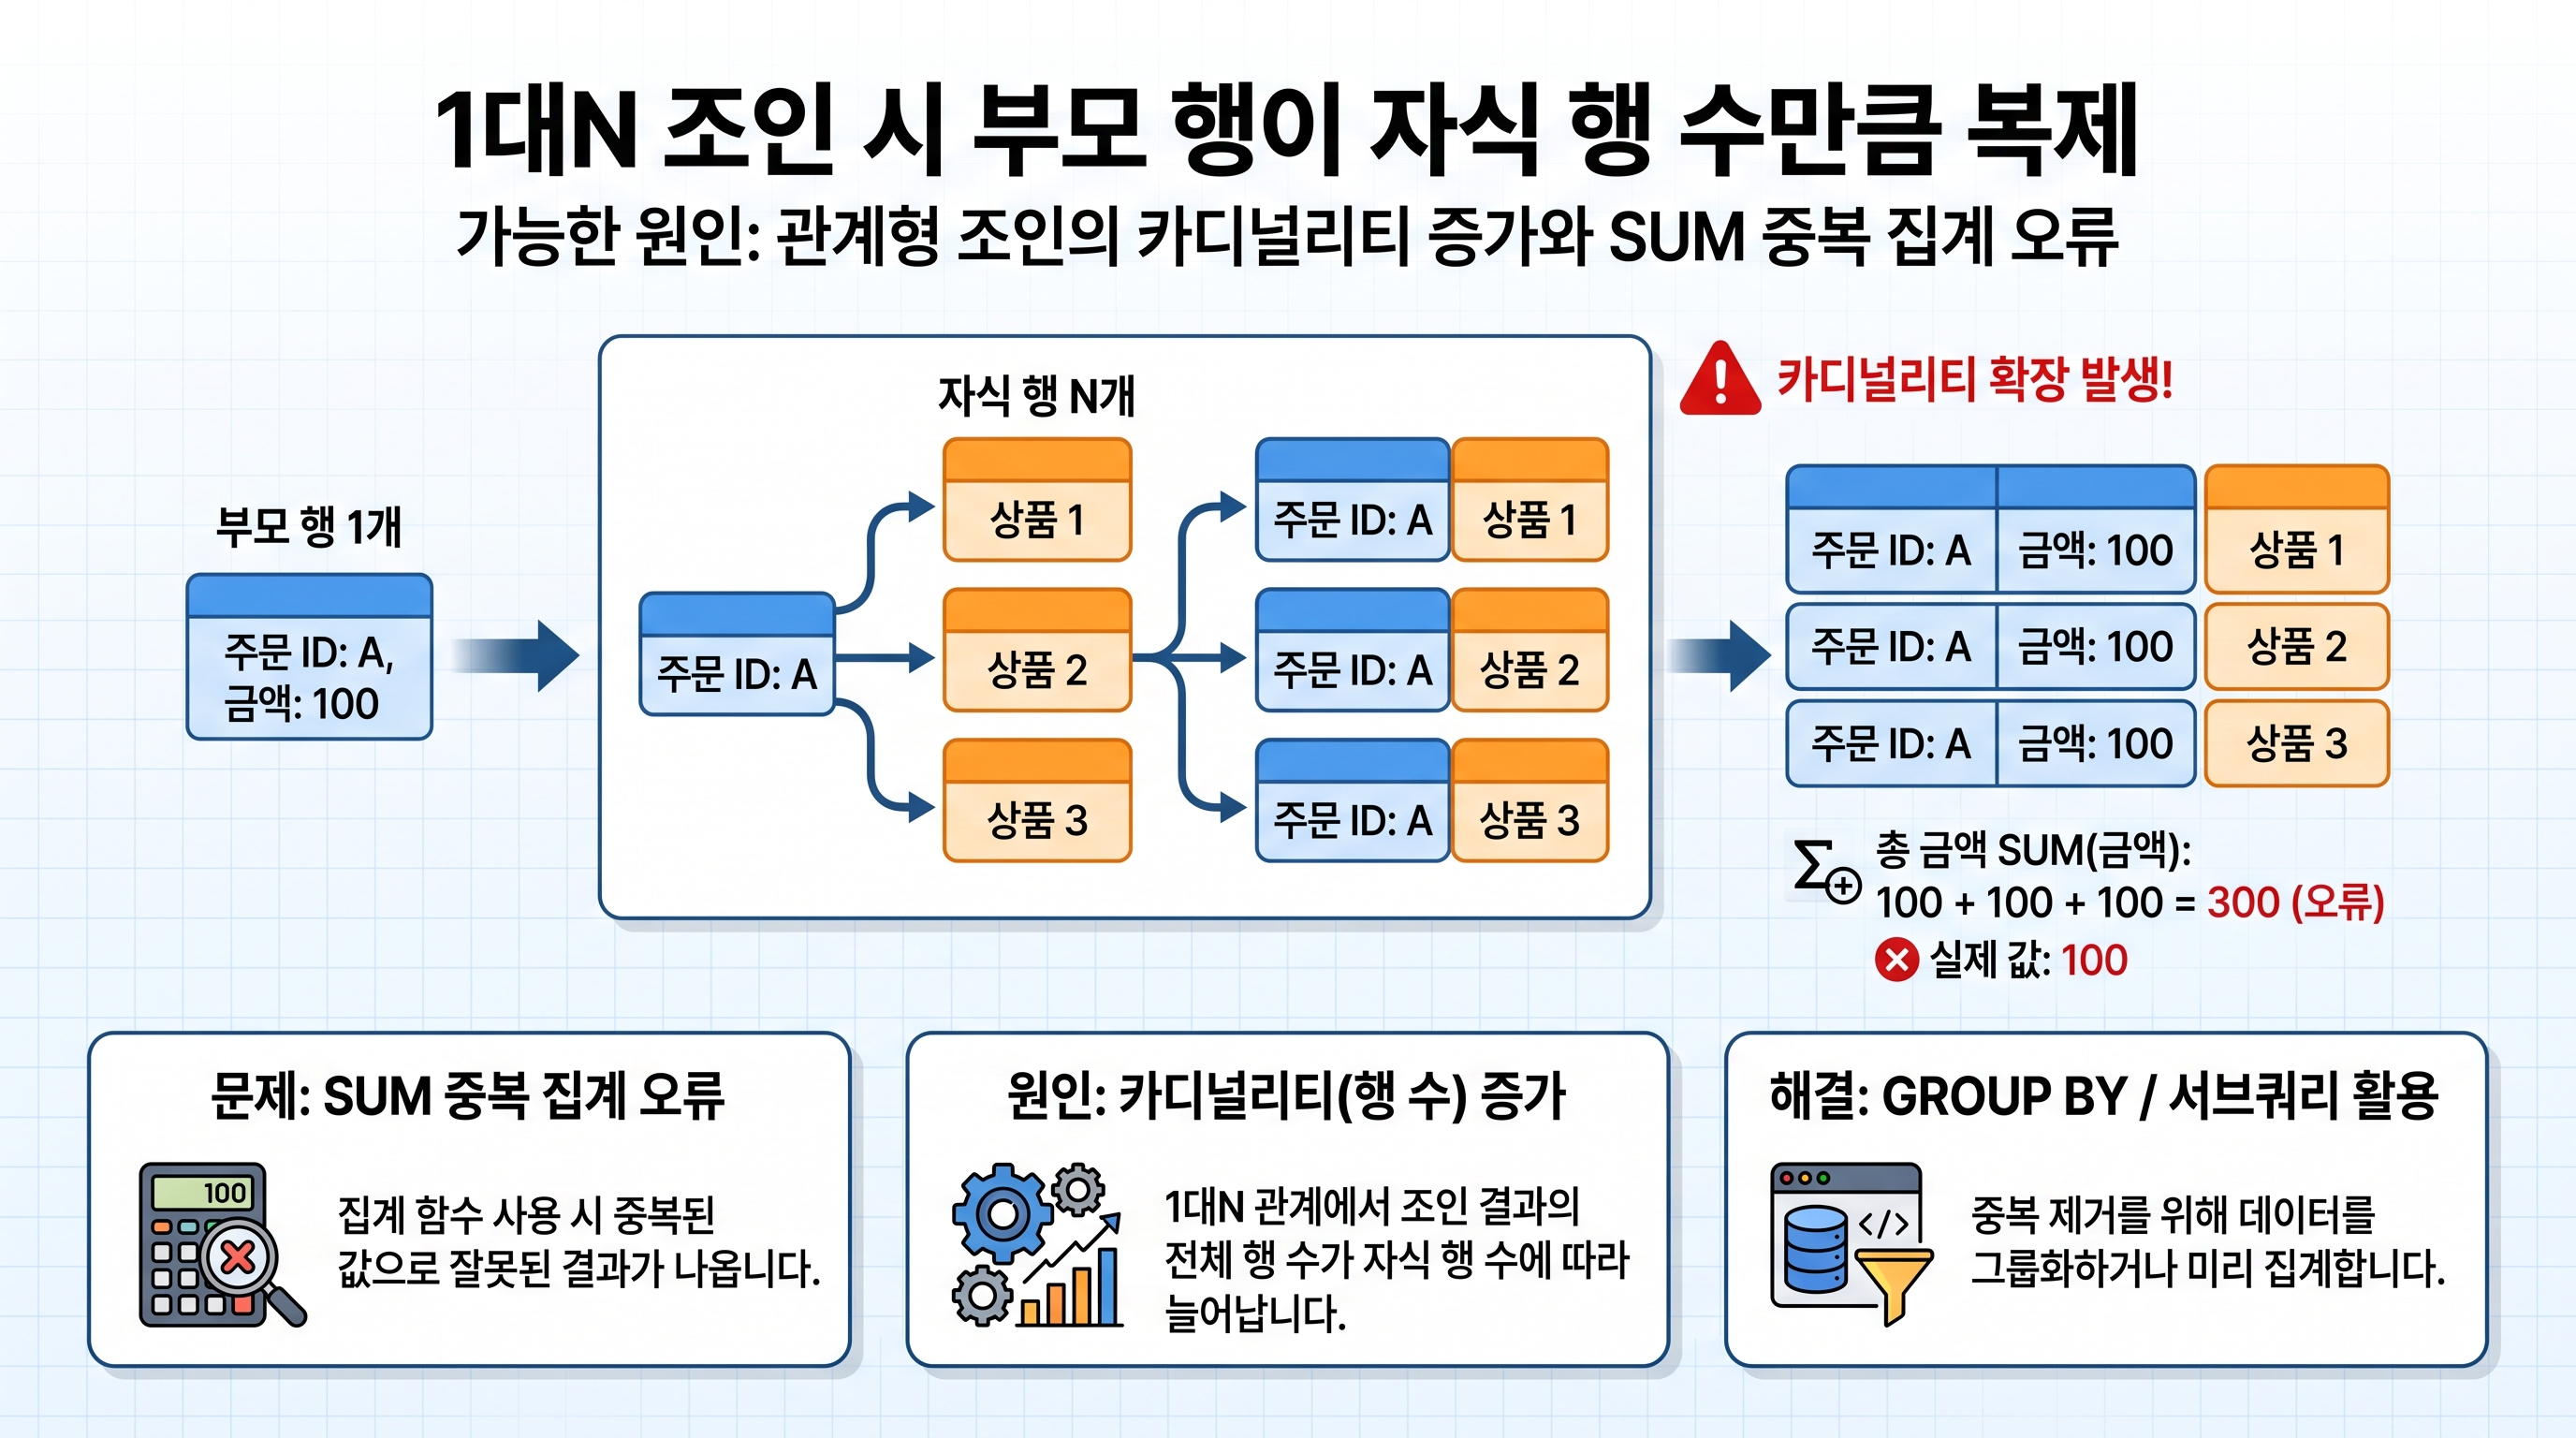
이와 같은 집계 왜곡이 발생하는 근본적인 원인은 관계형 데이터베이스의 JOIN 연산 동작 방식에 있습니다. RDBMS에서 1대N 관계를 맺고 있는 두 테이블을 INNER JOIN 또는 LEFT JOIN하면, 최종 결과 집합의 행(row) 개수는 부모 테이블 기준이 아니라 자식 테이블의 행 개수에 맞춰 늘어납니다. 즉, 주문 테이블에 1개 행만 존재하더라도 주문 품목 테이블에 연관된 행이 3개 있다면 조인 결과셋은 총 3개의 행으로 복제되어 펼쳐집니다.
문제는 이 상태에서 집계 함수인 SUM()을 호출할 때 발생합니다. 데이터베이스 엔진은 GROUP BY를 적용하기 전에 조인된 중간 결과셋을 먼저 생성합니다. 이미 3개의 행으로 늘어난 상태에서 `orders.total_amount` 컬럼의 값을 SUM 처리하게 되므로, 동일한 주문 금액이 각 행마다 1번씩 총 3번 더해지게 됩니다. 이는 데이터베이스의 오류가 아니라 관계 대수(Relational Algebra) 연산 규칙에 따른 정상적인 동작이지만, 개발자가 1대N 카디널리티의 변화를 고려하지 않고 집계 함수를 적용했기 때문에 발생하는 논리적 오류입니다.
확인 순서: 집계 함수 제거 후 원시 데이터 행 개수와 중복 확인
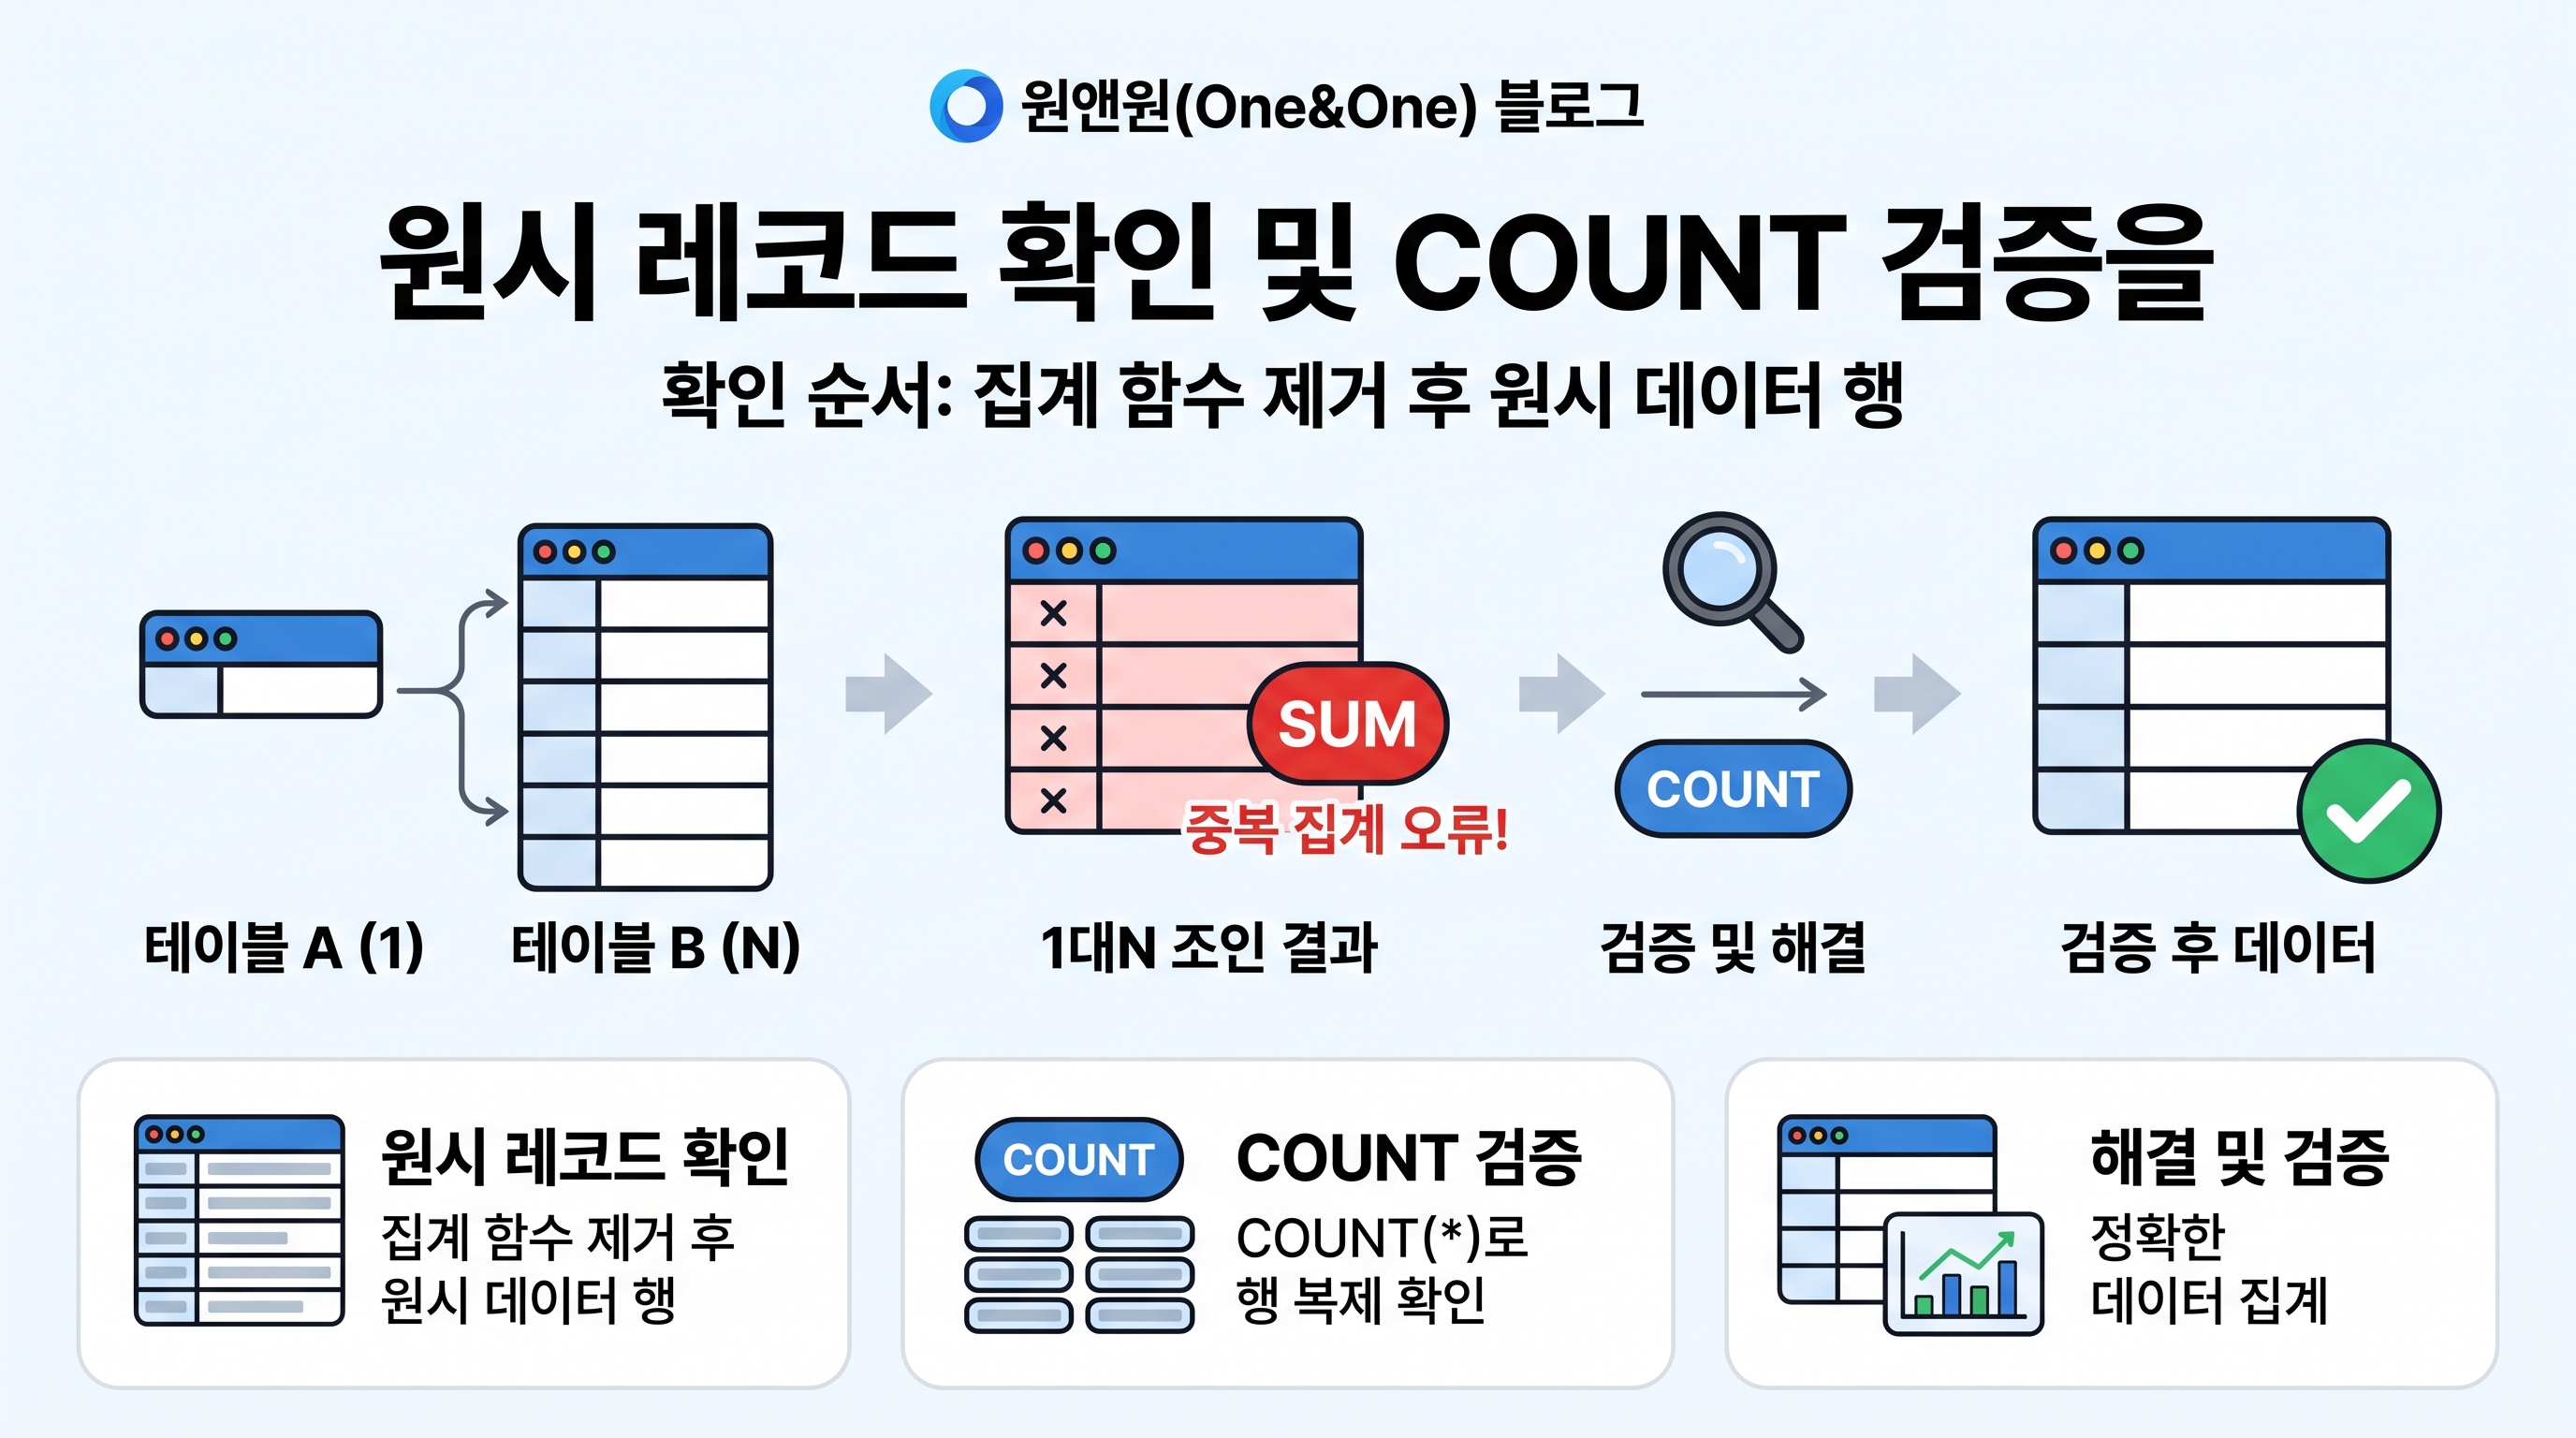
중복 집계 의심 증상이 확인되면 가장 먼저 집계 함수(SUM, COUNT 등)와 GROUP BY 구문을 잠시 제거하고 원시(Raw) 데이터를 직접 눈으로 확인해야 합니다. 작성한 조인 쿼리에서 SELECT 절을 `SELECT orders.order_id, orders.total_amount, order_items.item_id, order_items.quantity` 형태로 단순화하여 실행해 봅니다. 반환된 테이블에서 동일한 `order_id`와 `total_amount`가 여러 행에 걸쳐 반복 노출되는지 점검하는 것이 첫 번째 단계입니다.
그 다음으로 부모 테이블의 고유 식별자(PK)를 기준으로 `COUNT(DISTINCT orders.order_id)`와 전체 조인 행 개수인 `COUNT(*)`를 비교합니다. 만약 주문 ID의 고유 개수는 10개인데 전체 행 개수가 35개로 나온다면, 최소 25개의 부모 행이 자식 레코드와의 조인 과정에서 복제되었음을 즉시 증명할 수 있습니다. 마지막으로 자식 테이블 쪽에 1대N 관계가 중첩되어 또 다른 손자 테이블(예: 결제 내역, 배송 추적)까지 1대N대M 형태로 추가 조인되어 카디널리티가 기하급수적으로 폭증하고 있지 않은지 테이블 조인 경로를 단계별로 검증해야 합니다.
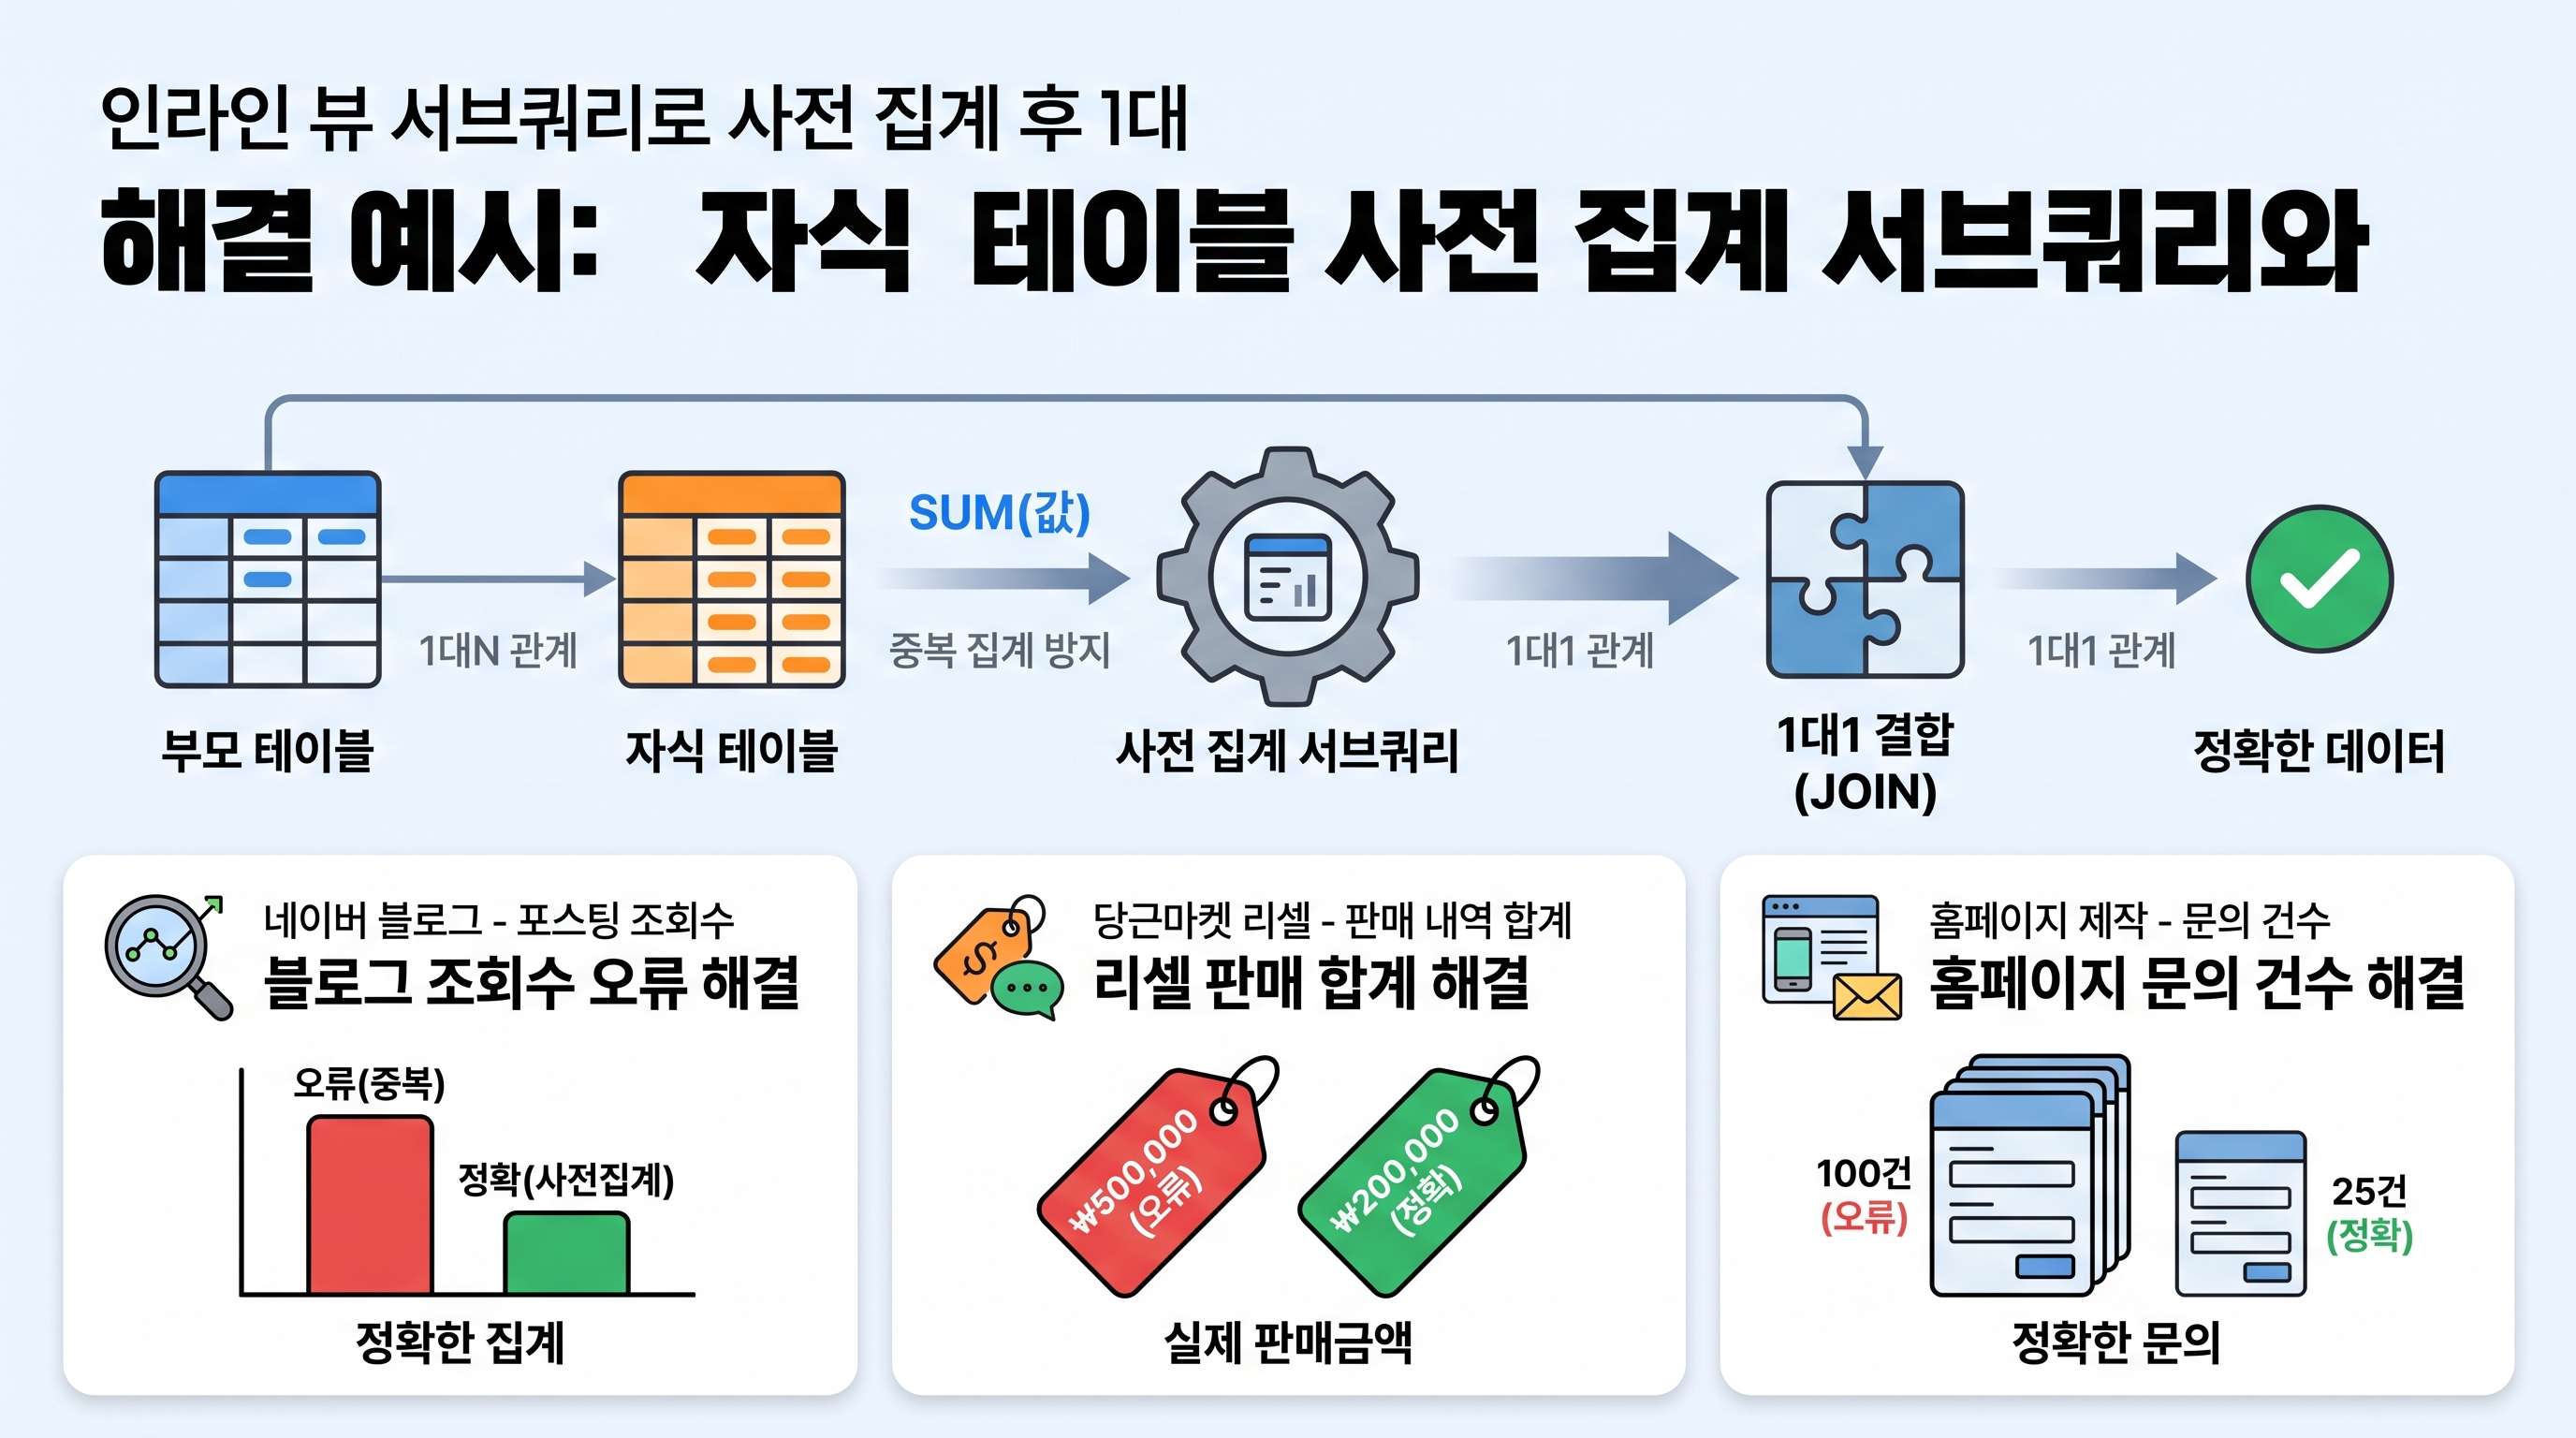
해결 예시: 자식 테이블 사전 집계 서브쿼리와 인라인 뷰 적용
이 문제를 해결하는 가장 안전하고 표준적인 방법은 조인을 수행하기 전에 1대N의 'N'에 해당하는 자식 테이블을 서브쿼리(인라인 뷰)나 CTE(WITH절)를 통해 1대1 수준으로 먼저 집계하는 것입니다. 자식 테이블에서 `order_id` 단위로 수량을 미리 합산해둔 뒤 부모 테이블과 1대1 관계로 조인하면 부모 행이 복제되는 현상 자체를 차단할 수 있습니다.
구체적인 SQL 작성 예시는 다음과 같습니다. 부모 테이블과 자식 테이블을 바로 붙이지 않고, FROM orders o LEFT JOIN (SELECT order_id, SUM(quantity) AS total_qty FROM order_items GROUP BY order_id) items_summary ON o.order_id = items_summary.order_id 형태로 구성합니다. 이렇게 하면 items_summary 인라인 뷰는 주문 ID당 정확히 1개의 집계 행만 반환하므로, orders 테이블의 `total_amount`는 1대1 결합을 유지하여 중복 없이 정확한 SUM 집계를 산출할 수 있습니다. 경우에 따라서는 부모 테이블을 기준으로 집계하는 쿼리와 자식 테이블을 기준으로 집계하는 쿼리를 각각 분리하여 작성하거나, 분석용 데이터베이스 환경이라면 윈도우 함수(ROW_NUMBER() OVER ...)를 활용해 최초 1개 행에만 금액을 반영하도록 조건식을 제어할 수도 있습니다.
재발 방지: 다대일·일대다 혼합 쿼리 작성 원칙과 코드 리뷰 수칙
1대N 중복 집계 오류를 근본적으로 예방하기 위해서는 쿼리 작성 단계에서 카디널리티 수준을 명확히 정의하는 습관이 필수적입니다. 데이터 모델링 상에서 1대N 관계가 존재하는 테이블끼리 조인할 때는 '부모 테이블 컬럼의 집계가 필요한가?'를 항상 자문해야 합니다. 만약 부모 테이블의 숫자 컬럼을 SUM해야 하는 요구사항이 있다면, 자식 테이블과의 직접적인 조인은 지양하고 사전 집계 서브쿼리를 기본 설계 원칙으로 삼아야 합니다.
팀 단위 개발 환경에서는 코드 리뷰 시 다음과 같은 체크리스트를 적용할 것을 권장합니다. 첫째, 조인 조건에 포함된 외래키(FK) 컬럼의 유니크 제약 여부를 확인하고 1대N 결합 여부를 명시하도록 합니다. 둘째, DISTINCT를 무분별하게 SUM 함수 내부(예: SUM(DISTINCT amount))에 사용하는 임시방편을 금지해야 합니다. 우연히 서로 다른 주문의 결제 금액이 10,000원으로 동일할 경우 정당한 데이터마저 중복으로 간주해 누락되는 더 심각한 버그를 초래하기 때문입니다. 셋째, 쿼리 작성 후에는 복수 자식 레코드를 포함한 경계값 테스트 케이스를 의무적으로 실행하여 집계 일관성을 검증하는 프로세스를 정착시켜야 합니다.
