AI 음성 전사 고유명사 전문용어 오인식 교정 프롬프트 설정 및 후처리 해결법
AI 음성 전사(STT) 도구에서 브랜드명, 신조어, 전문용어가 왜곡될 때 프롬프트 힌트 설정과 텍스트 LLM 사후 보정을 활용해 오류를 정확히 바로잡는 실무 해결 가이드입니다.
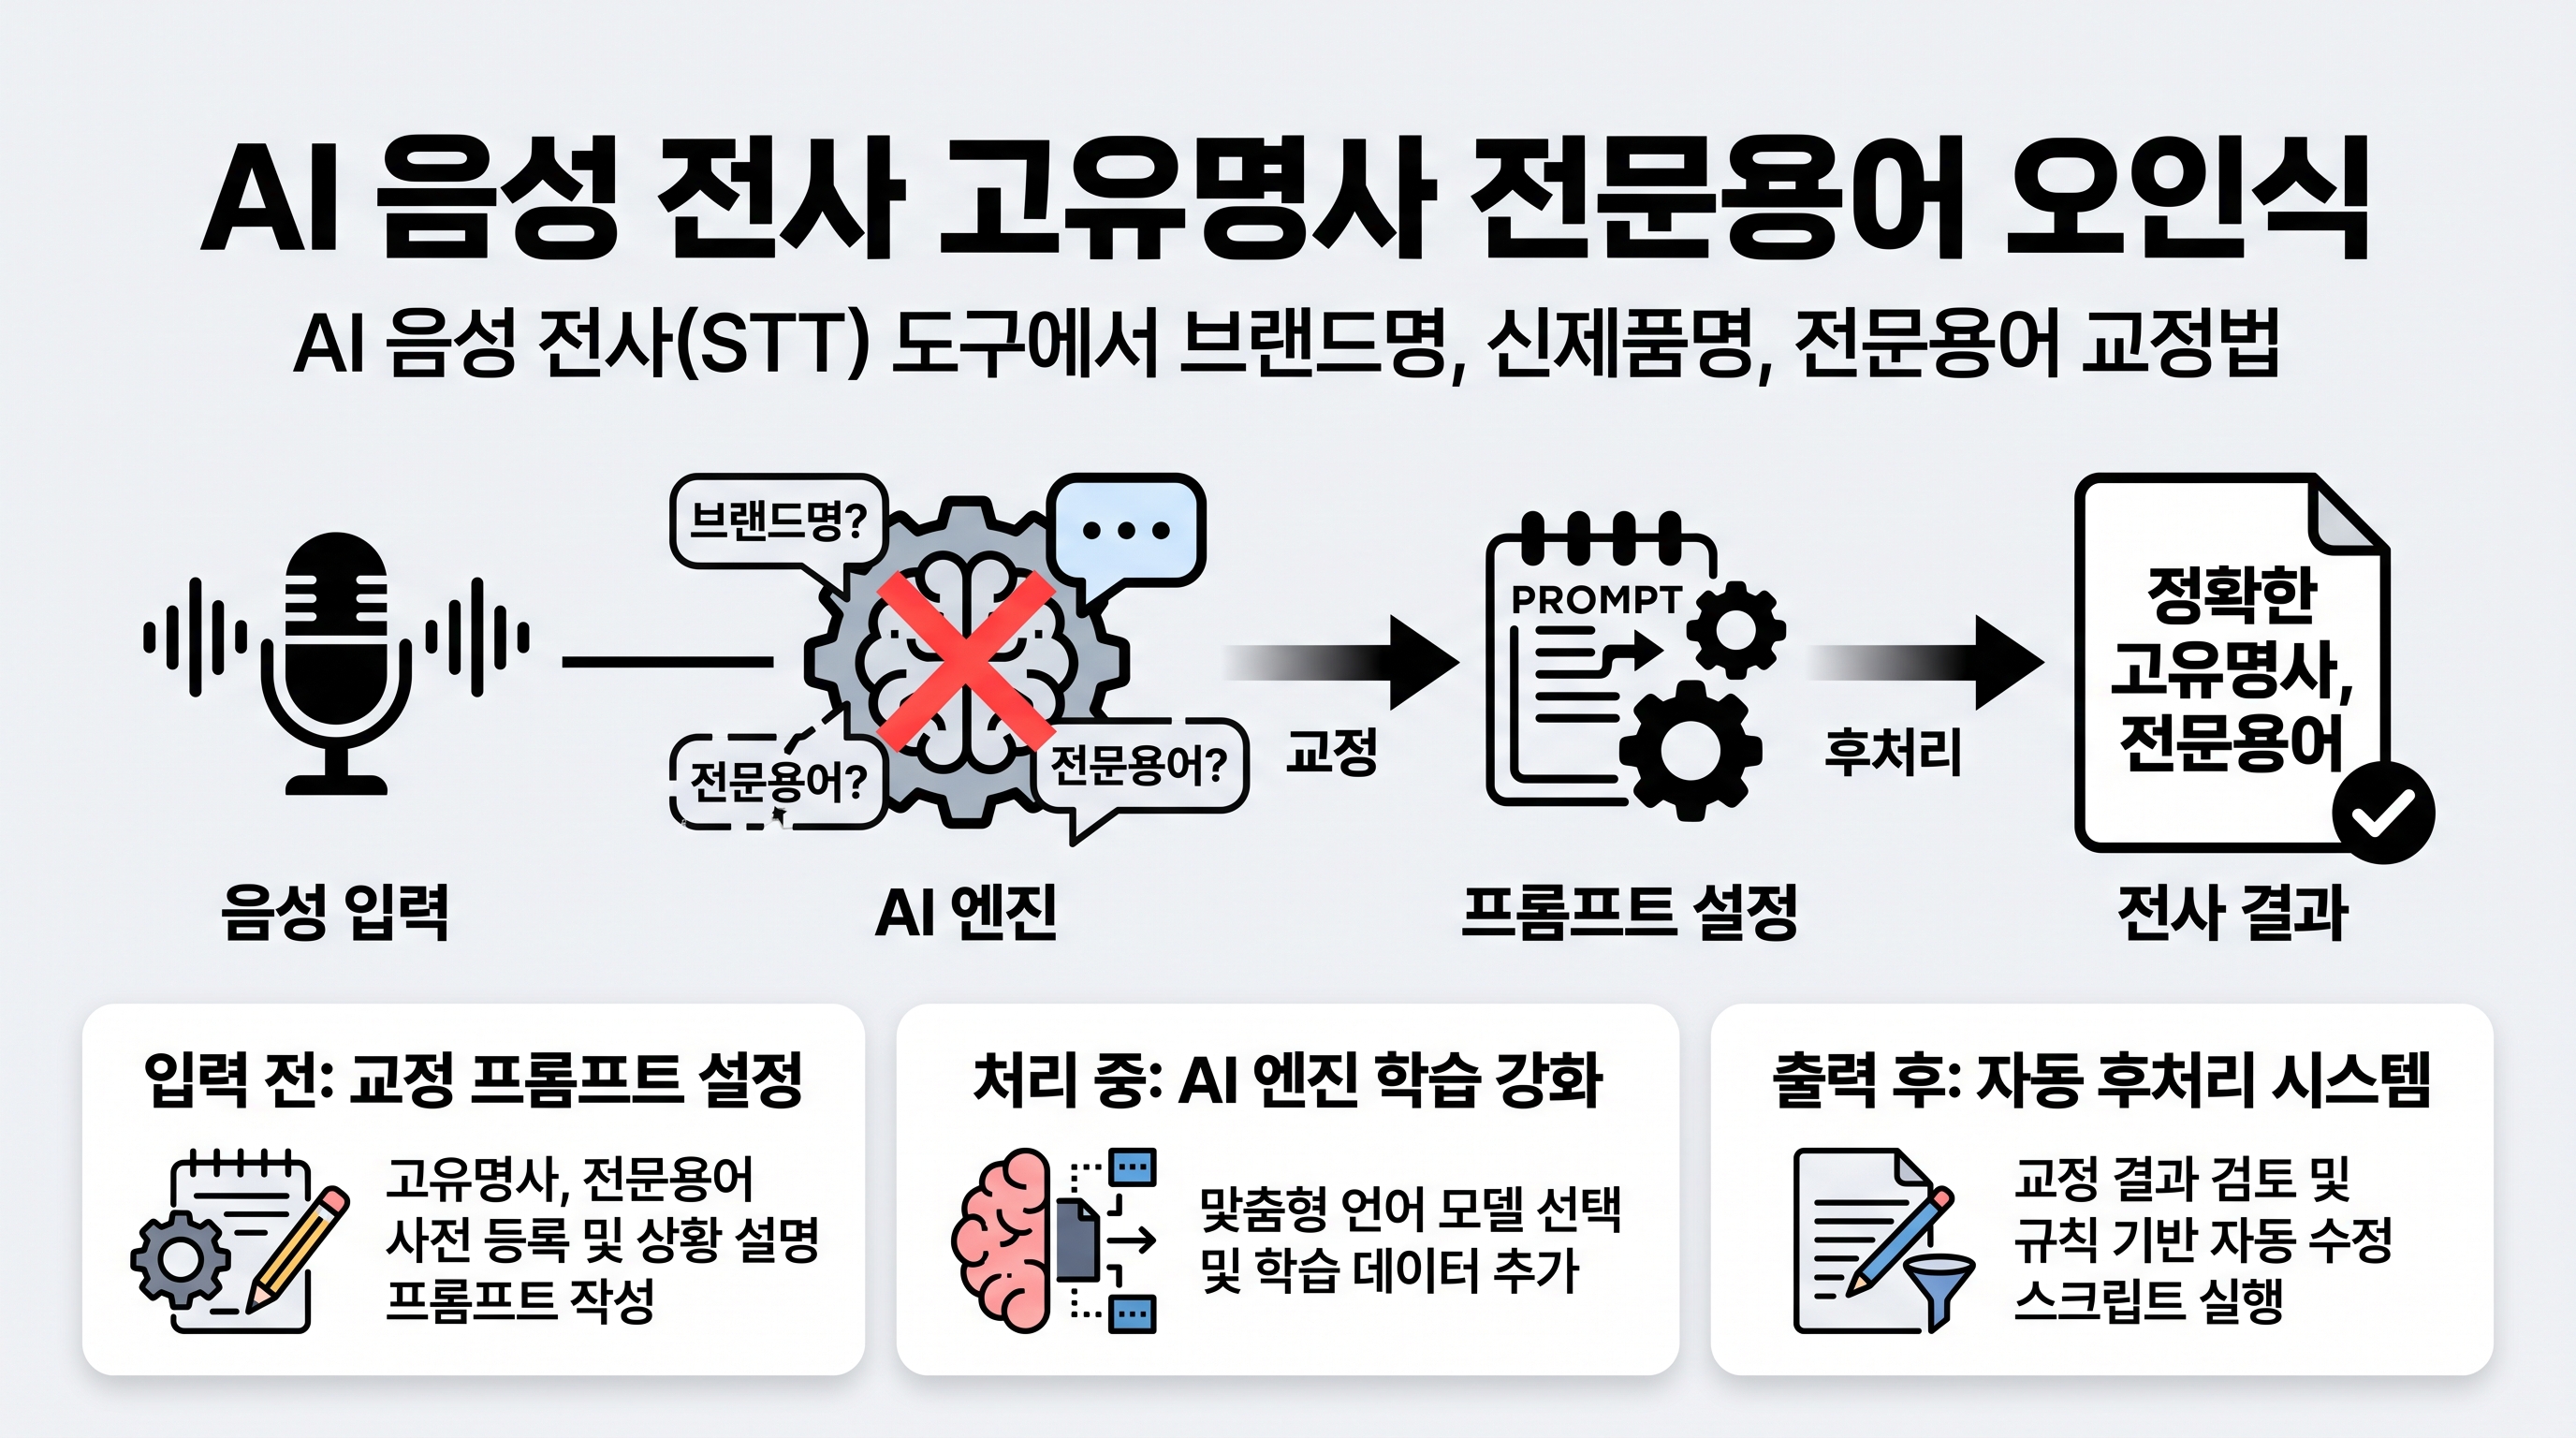
증상과 재현 조건: 유사 발음으로 둔갑하는 고유명사와 전문용어
인터뷰, 고객 미팅, 사내 기술 회의를 녹음한 뒤 Whisper나 클로바노트 같은 AI 음성 전사(STT) 도구를 실행하면, 일반적인 문맥은 매끄럽게 변환되지만 특정 단어만 엉뚱한 한글이나 영어로 바뀌는 현상이 자주 발생합니다. 예를 들어 사내 프로젝트 코드명, 특허 기술명, 브랜드명, 영문 약어(SaaS, API, ROI 등)가 발음이 비슷한 엉뚱한 일상 단어로 치환되어 전체 맥락이 흐트러지는 것이 대표적인 재현 증상입니다.
이러한 현상은 주로 일반 대화 코퍼스로 사전 학습된 기본 모델을 사용할 때 두드러집니다. 발화자가 명확한 억양으로 발음하더라도, 사전 데이터에 없는 특수 도메인 어휘는 언어 모델이 통계적으로 등장 확률이 더 높은 대중적인 단어로 강제 치환해 버리기 때문입니다. 결과적으로 수십 페이지의 회의록에서 수작업으로 단어를 하나하나 찾아 고쳐야 하는 불필요한 공수가 발생하게 됩니다.
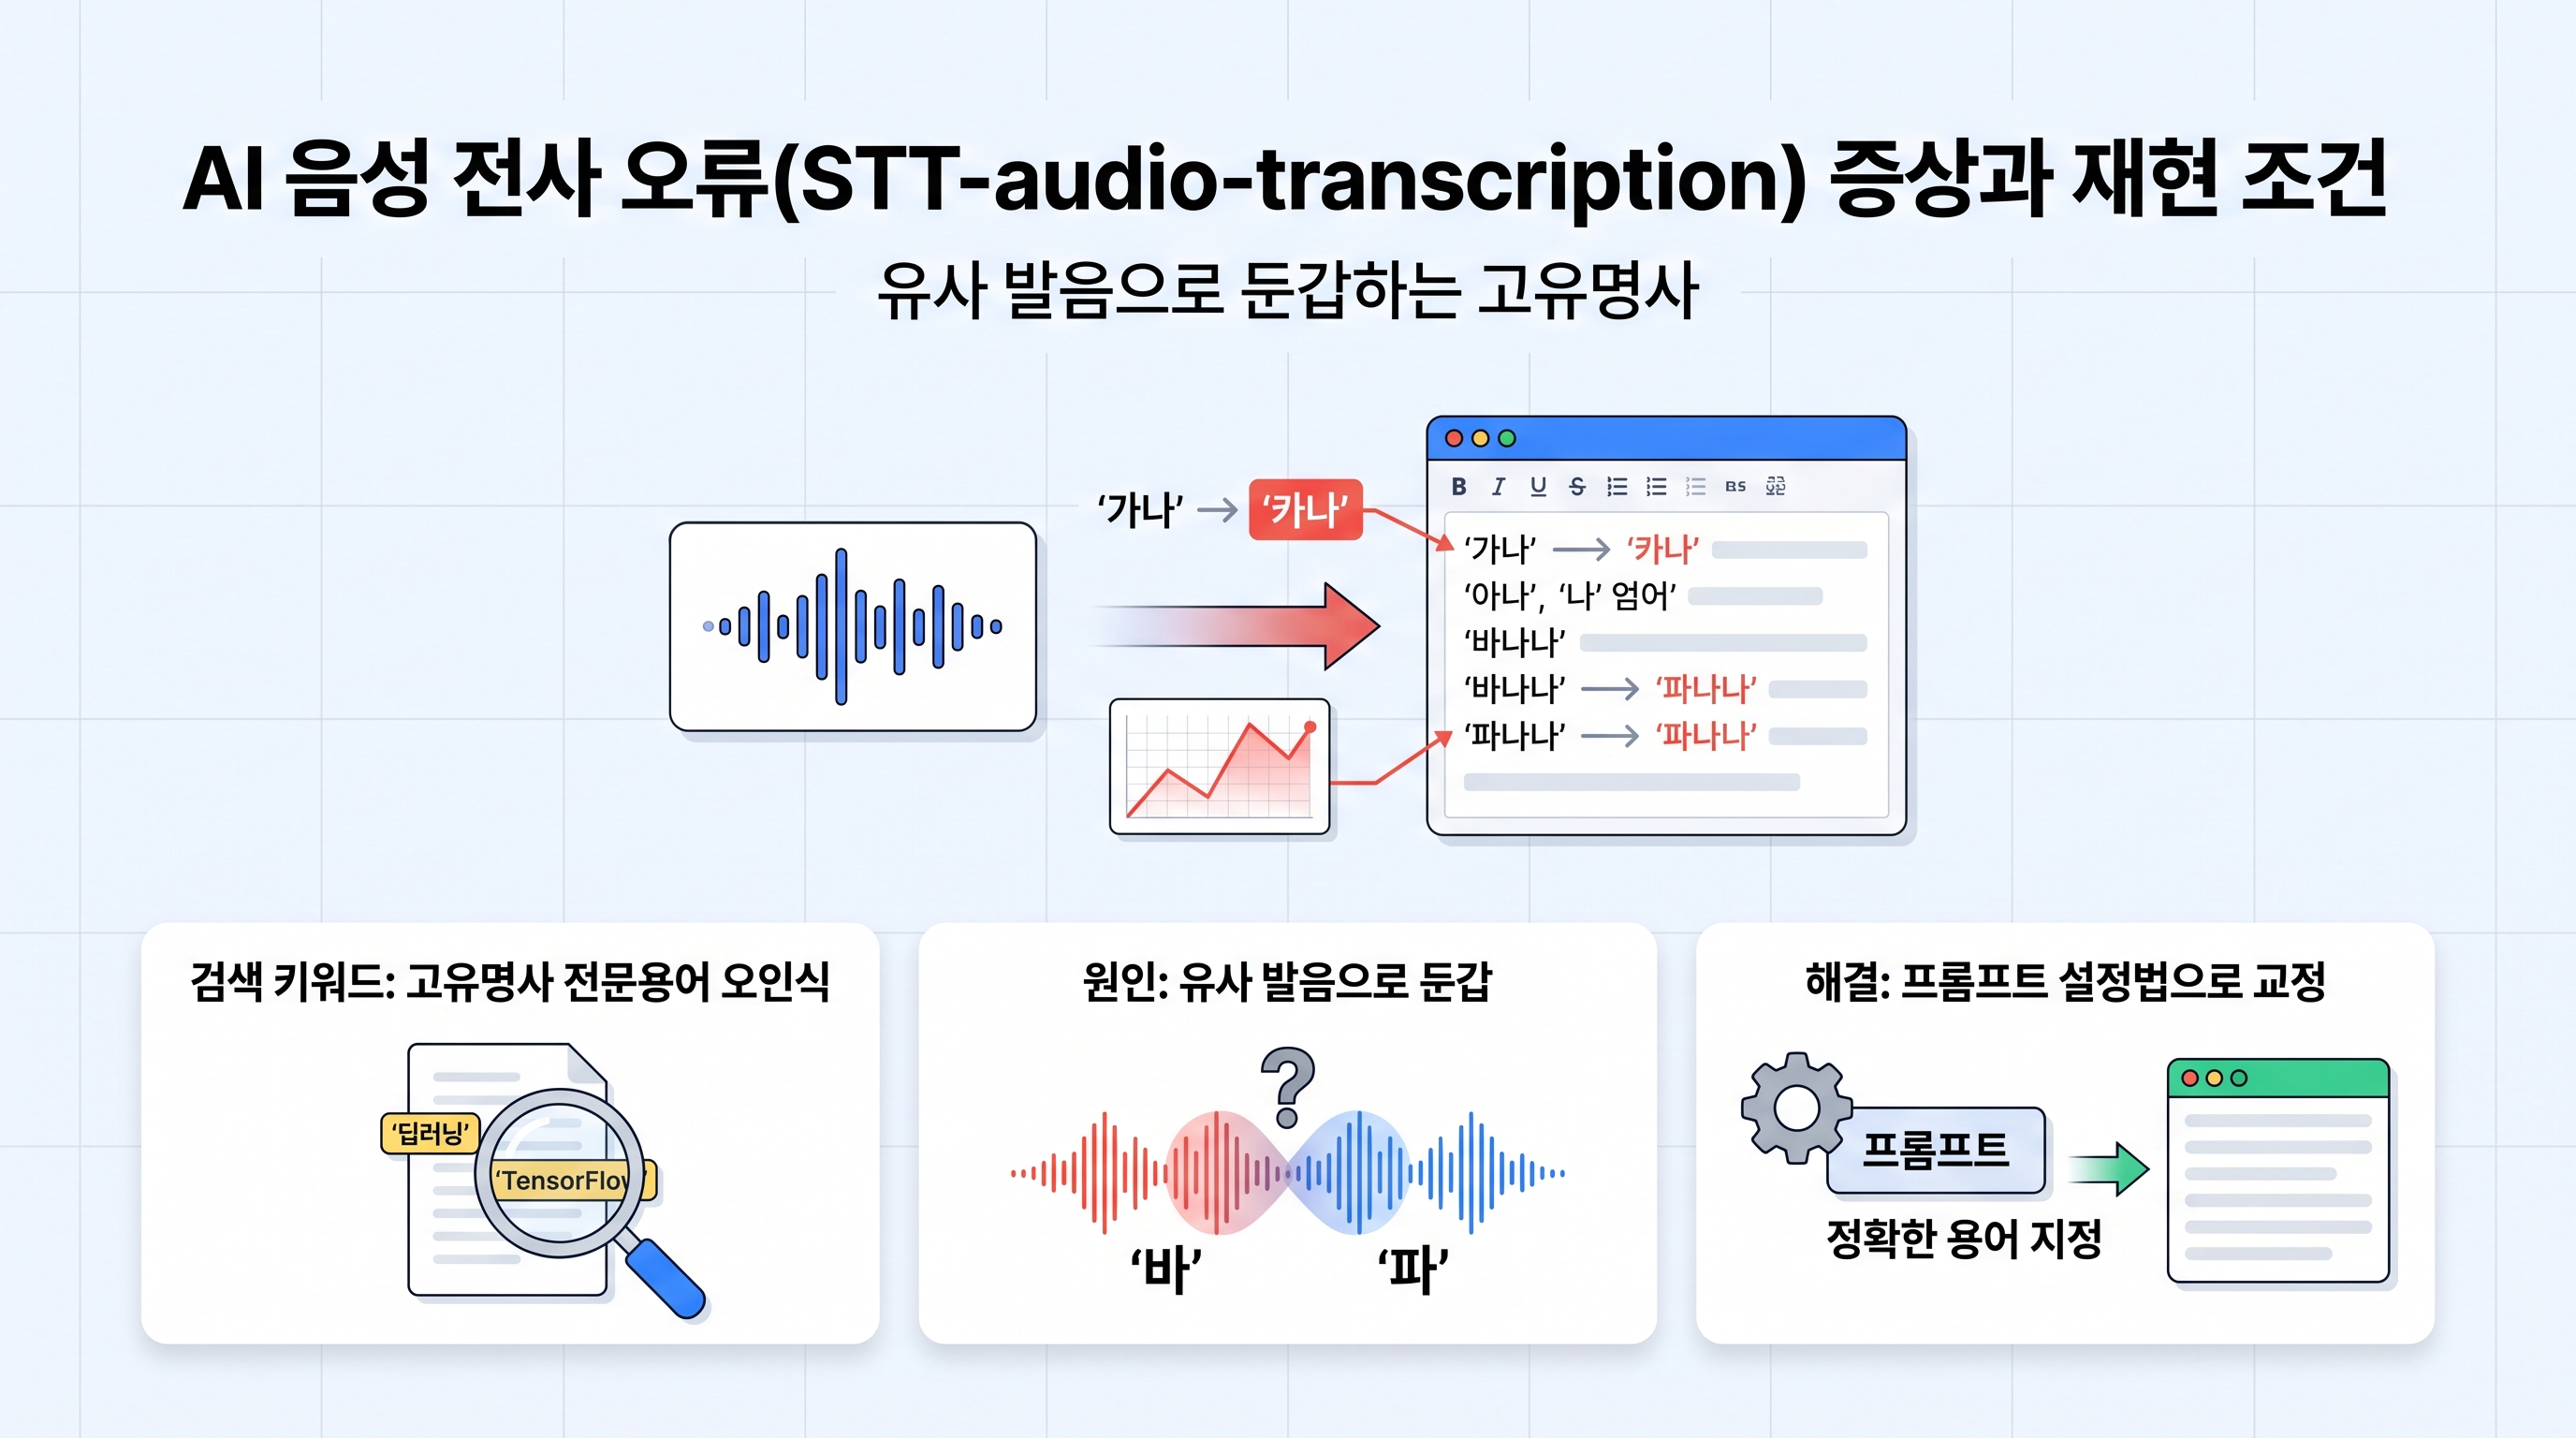
원인 분석: 음향 모델의 한계와 언어 모델의 확률적 단어 치환
AI 음성 전사 기술은 소리 파형을 음소로 분리하는 '음향 모델'과 앞뒤 단어의 연결 확률을 계산해 자연스러운 문장으로 조합하는 '언어 모델'이 결합되어 작동합니다. 고유명사 오인식의 가장 큰 원인은 언어 모델이 가진 사전 어휘집의 한계에 있습니다. 모델이 학습하지 못한 생소한 스타트업 이름이나 산업 전문 용어는 음향적으로 완벽히 수음되더라도 확률 계산 과정에서 사전에 존재하는 가장 발음이 유사한 단어로 왜곡됩니다.
또 다른 원인은 배경 잡음이나 마이크 품질로 인한 발음 뭉개짐입니다. 특히 회의실 마이크 울림이 있거나 두 명 이상이 동시에 말하는 환경에서는 음향 모델 단계에서 자음과 모음의 특징이 손실됩니다. 이때 언어 모델은 주변 맥락만을 단서로 삼아 결측된 정보를 채우려고 시도하며, 그 결과 도메인 특화 용어 대신 일상적인 관용구가 최종 텍스트로 확정되는 구조적 취약점이 발생합니다.
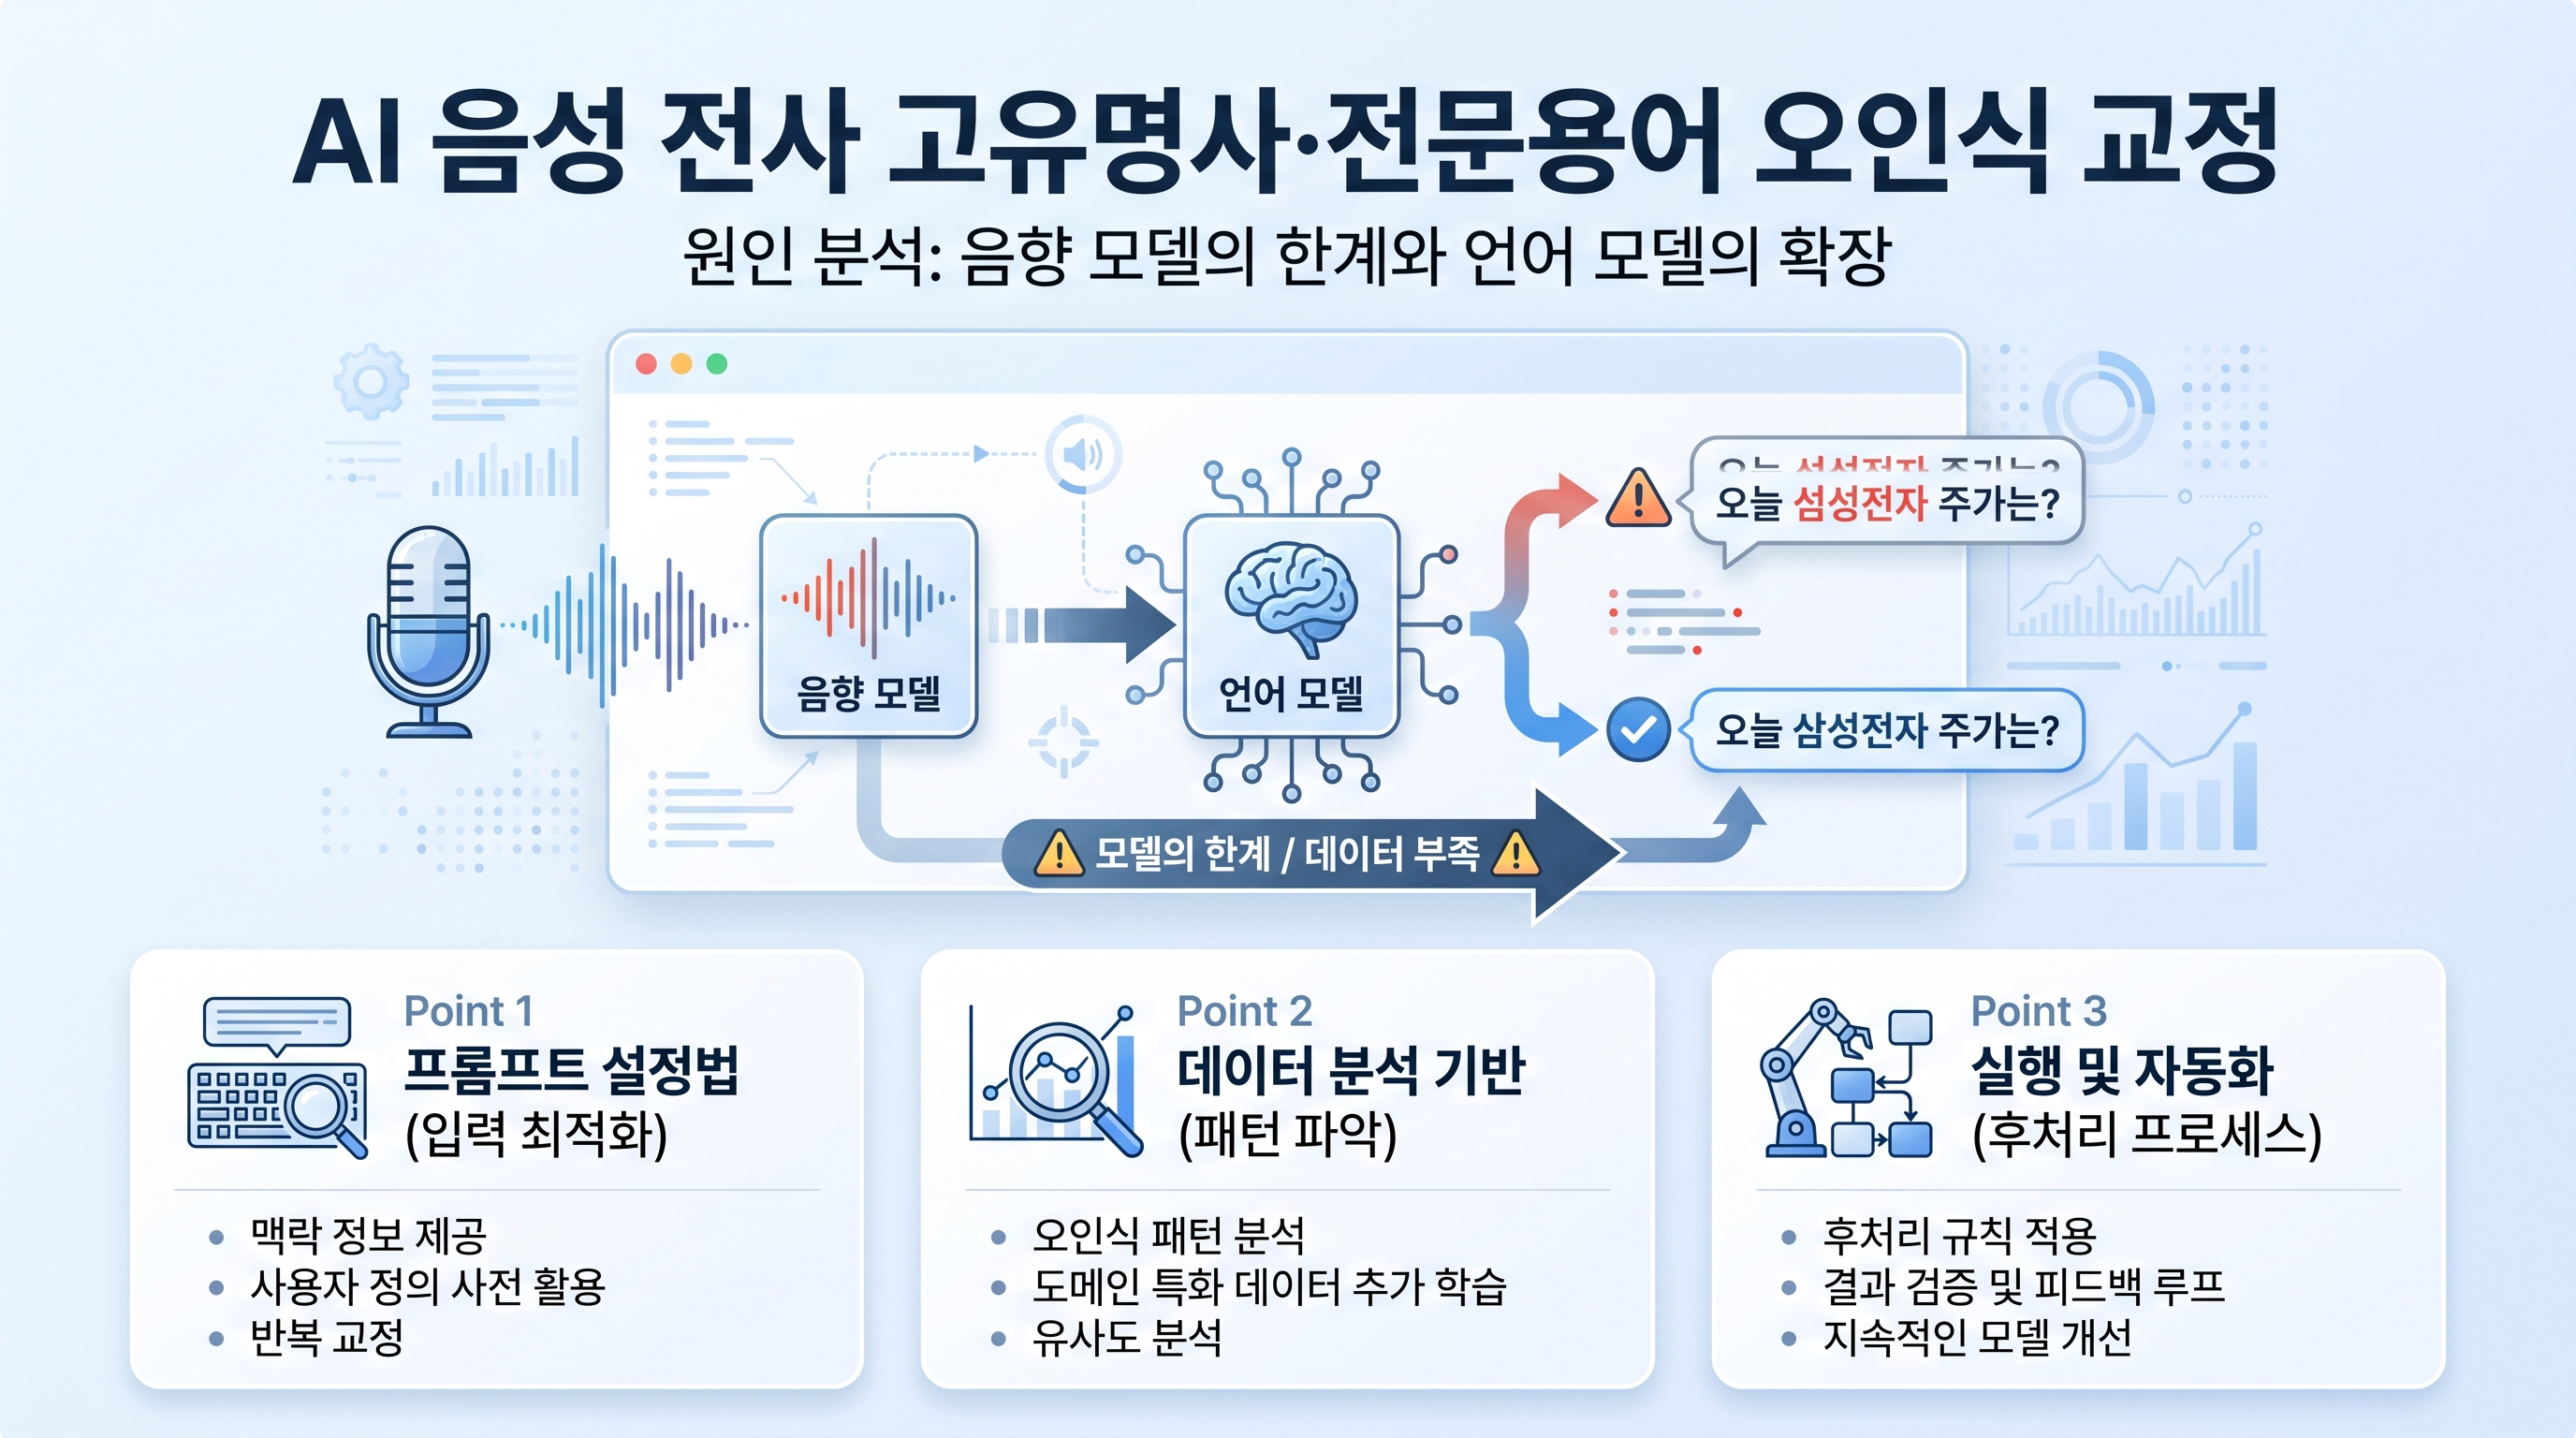
점검 순서: 전사 전 힌트 주입 가능 여부와 오인식 패턴 분류
문제를 해결하기 위해 먼저 사용 중인 음성 전사 도구가 '초기 프롬프트(Prompt)'나 '사용자 사전/키워드 부스팅' 기능을 지원하는지 확인해야 합니다. OpenAI의 Whisper API나 데스크톱 전사 툴은 텍스트 형태의 프롬프트를 전사 요청 시 함께 전달할 수 있어, 미리 언급될 단어를 모델의 주의(Attention) 영역에 올려놓을 수 있습니다. 반면 키워드 입력 인터페이스가 없는 도구라면 전사 완료 후 텍스트 기반으로 보정하는 2차 파이프라인을 준비해야 합니다.
다음으로 녹음본 내에서 반복해서 틀리는 어휘 목록을 정리합니다. 오인식 유형은 크게 세 가지로 나뉩니다. 첫째는 '외래어 및 약어 표기 불일치', 둘째는 '사내 전용 고유명사의 일상 단어 치환', 셋째는 '숫자 및 규격 단위 누락'입니다. 이처럼 오류 유형을 목록화해 두면 전사 전 프롬프트에 힌트로 제공할 단어 집합과 전사 후 사후 교정 프롬프트에 넣을 단어 매핑 사전을 명확히 분리할 수 있습니다.
해결 예시: 1차 힌트 프롬프트 설정과 2차 LLM 용어집 치환 프롬프트
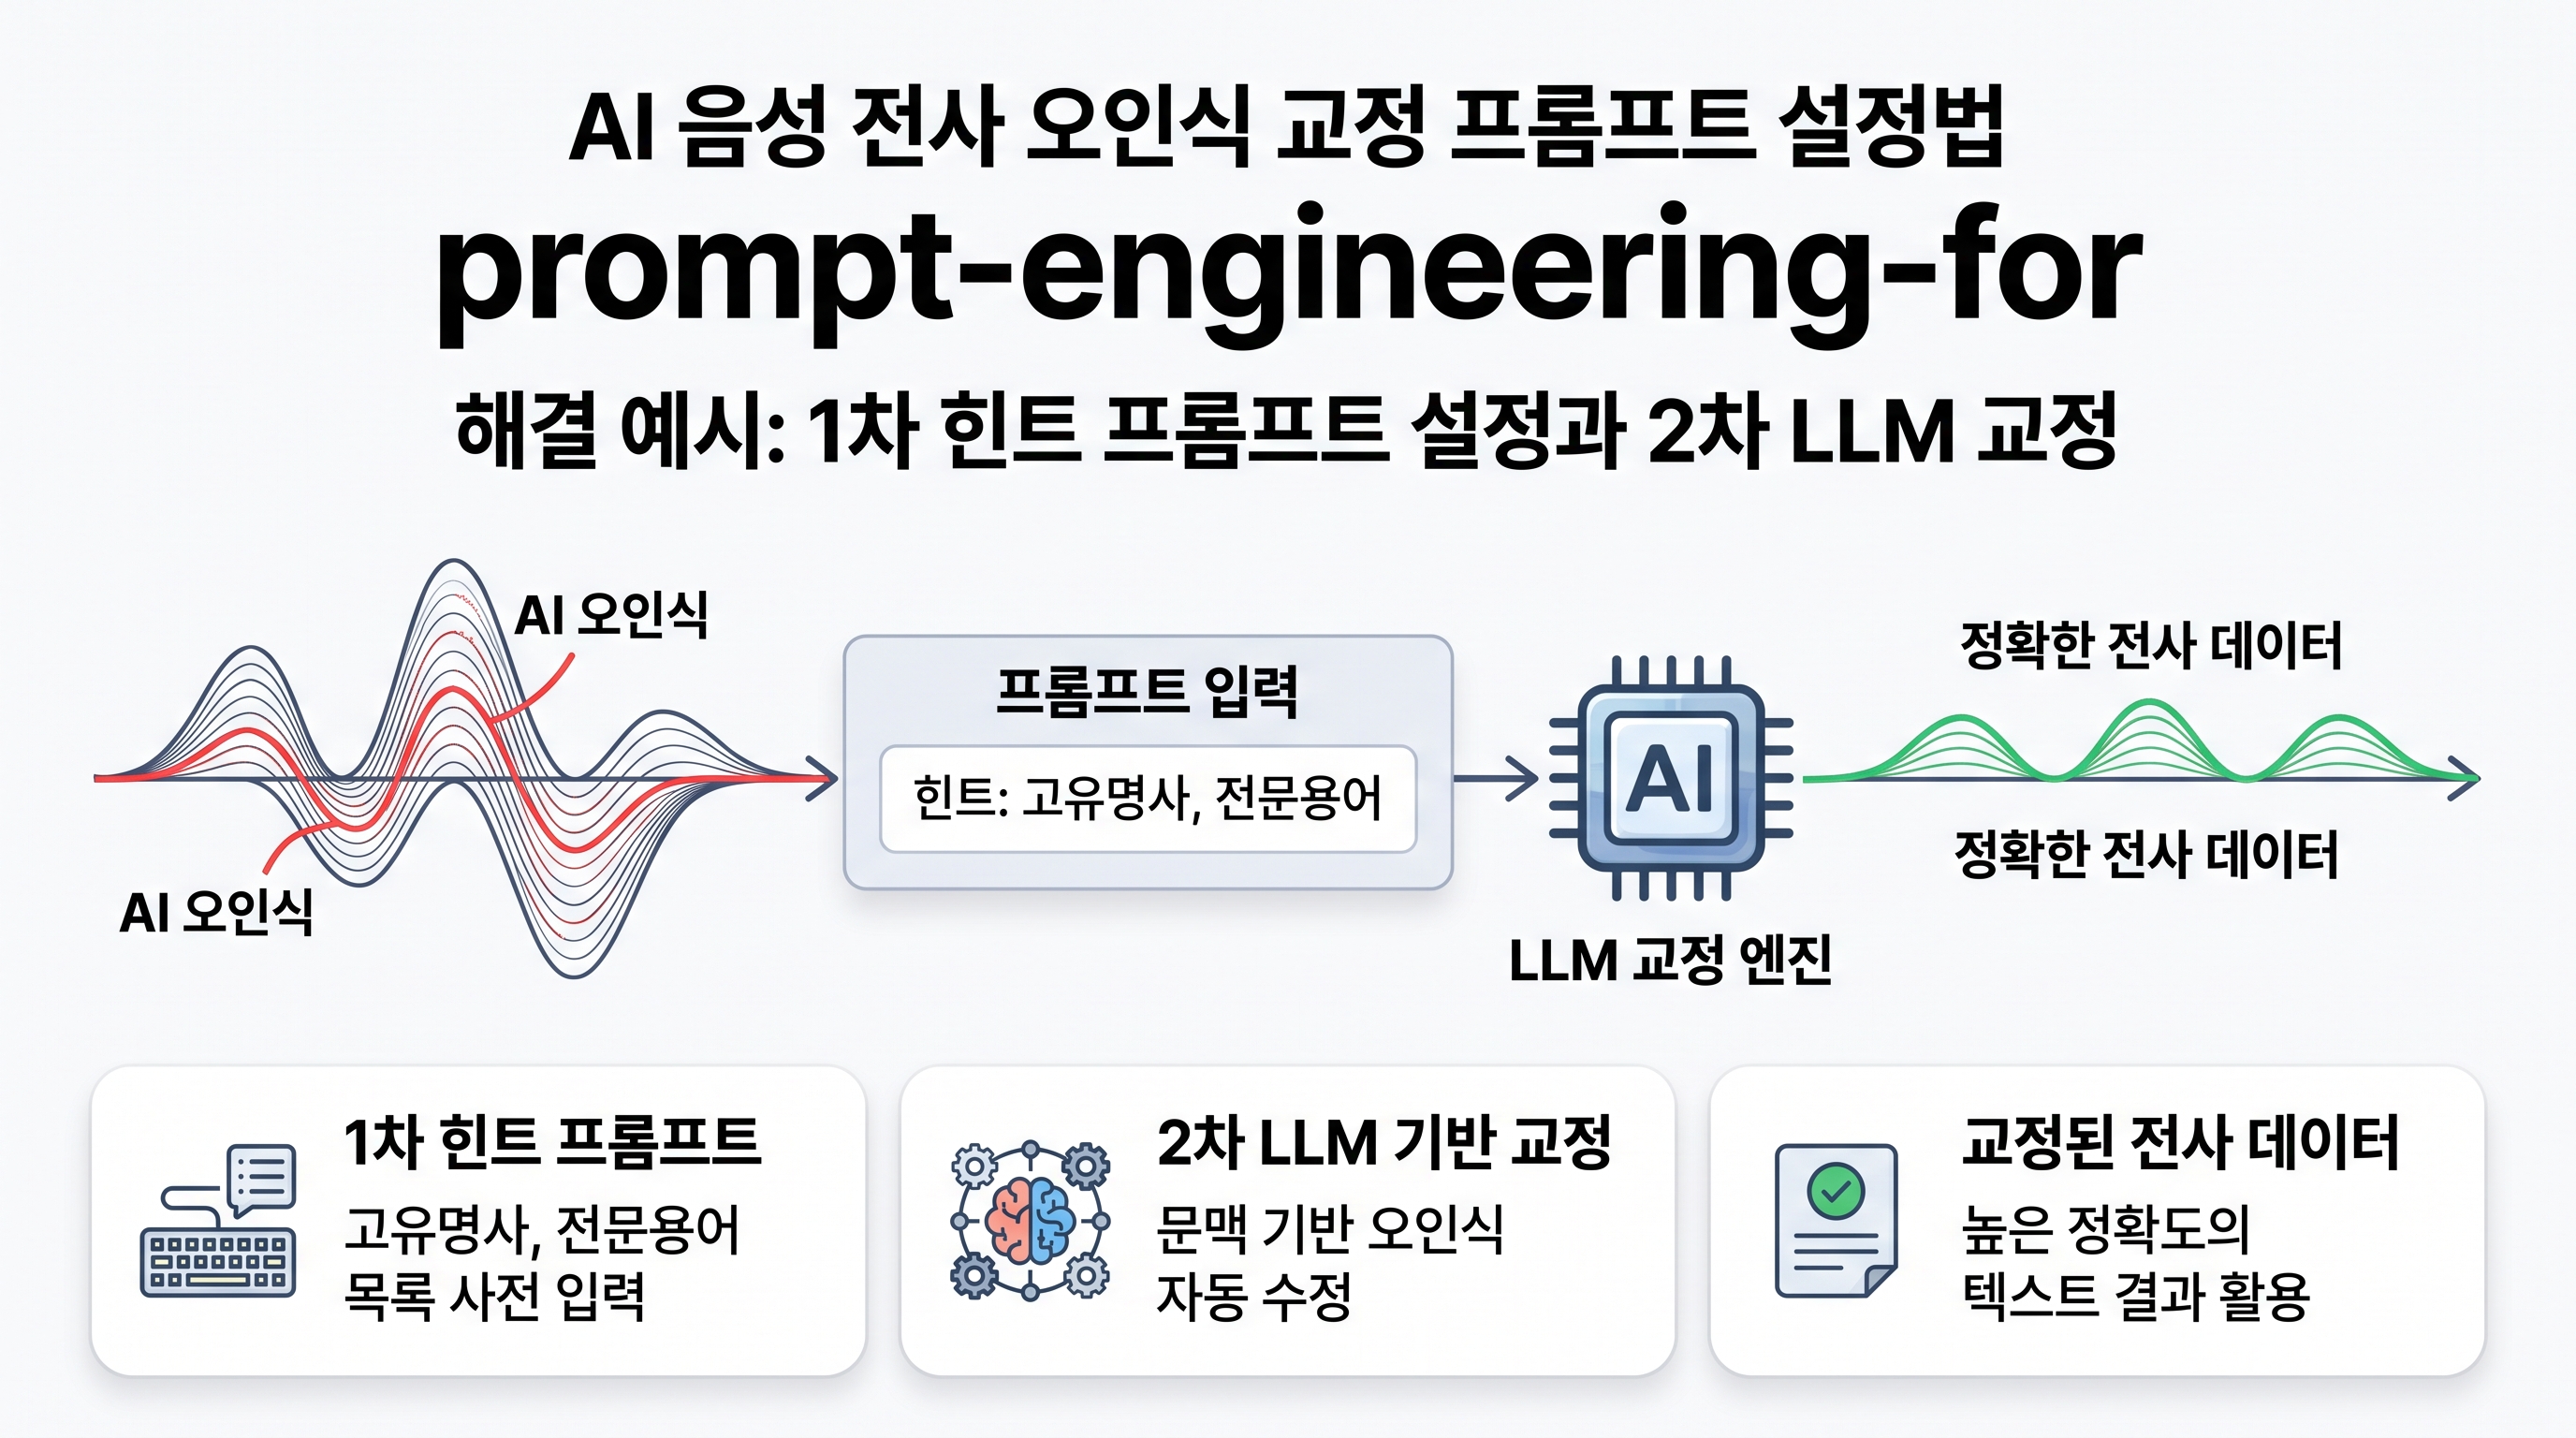
가장 효과적인 해결 방식은 '전사 시점 힌트 제공'과 '전사 직후 LLM 사후 교정'의 2단계 접근법입니다. Whisper 계열 도구를 사용한다면 API 호출 시 프롬프트 파라미터에 회의 주요 안건과 고유명사가 포함된 자연스러운 문장을 미리 입력합니다. 예를 들어 '이번 회의는 B2B SaaS 기업 넥스트웨이브의 엔터프라이즈 CRM 솔루션 마이그레이션과 API 연동에 관한 논의입니다.'와 같이 대상 단어를 포함해 두면 모델이 해당 단어의 출력 가중치를 높입니다.
초기 프롬프트 주입이 불가능하거나 여전히 오탈자가 남는 환경이라면, 전사 완료된 텍스트를 LLM(Claude, GPT 등)에 전달하여 사전 정의된 매핑 룰로 교정합니다. 프롬프트 예시는 다음과 같이 구성할 수 있습니다. '역할: 기술 회의록 교정자. 지시사항: 다음 전사 텍스트에서 음성 인식 오류로 잘못 변환된 전문용어를 [오인식 단어: 정확한 표기] 매핑 규칙에 따라 치환하세요. 문맥을 임의로 요약하거나 문장 구조를 바꾸지 말고, 지정된 어휘만 교정하여 전문을 출력하세요. 매핑 규칙: [에이피아이 -> API], [사스 -> SaaS], [넥스트웨이 -> 넥스트웨이브]'. 이 방식을 적용하면 원문 손실 없이 전문용어 표기를 정확하게 통일할 수 있습니다.
재발 방지: 회의 사전 용어집 구축과 표준 녹음 환경 관리
향후 유사한 전사 오류를 반복하지 않으려면 업무 프로세스 차원에서 '표준 회의 용어집(Glossary)'을 관리해야 합니다. 팀이나 프로젝트 단위로 자주 쓰는 고객사 사명, 인명, 서비스명, 기술 스택 목록을 텍스트 파일 하나로 정리해 두고, 전사 작업을 수행할 때마다 해당 목록을 복사하여 교정 프롬프트 템플릿에 붙여넣는 루틴을 정착시키는 것이 효율적입니다.
동시에 입력 오디오의 음향 품질을 일정 수준 이상으로 유지하는 노력이 병행되어야 합니다. 지향성 마이크를 사용하거나 화자와 마이크 사이 거리를 30cm 이내로 유지하고, 회의 전 5초간 실내 소음을 측정한 뒤 발화를 시작하는 것만으로도 음향 모델의 분별력이 크게 상승합니다. 잡음이 적은 깨끗한 오디오와 명확한 키워드 프롬프트가 결합될 때 오인식 교정에 소요되는 후속 편집 시간을 실질적으로 줄일 수 있습니다.
